
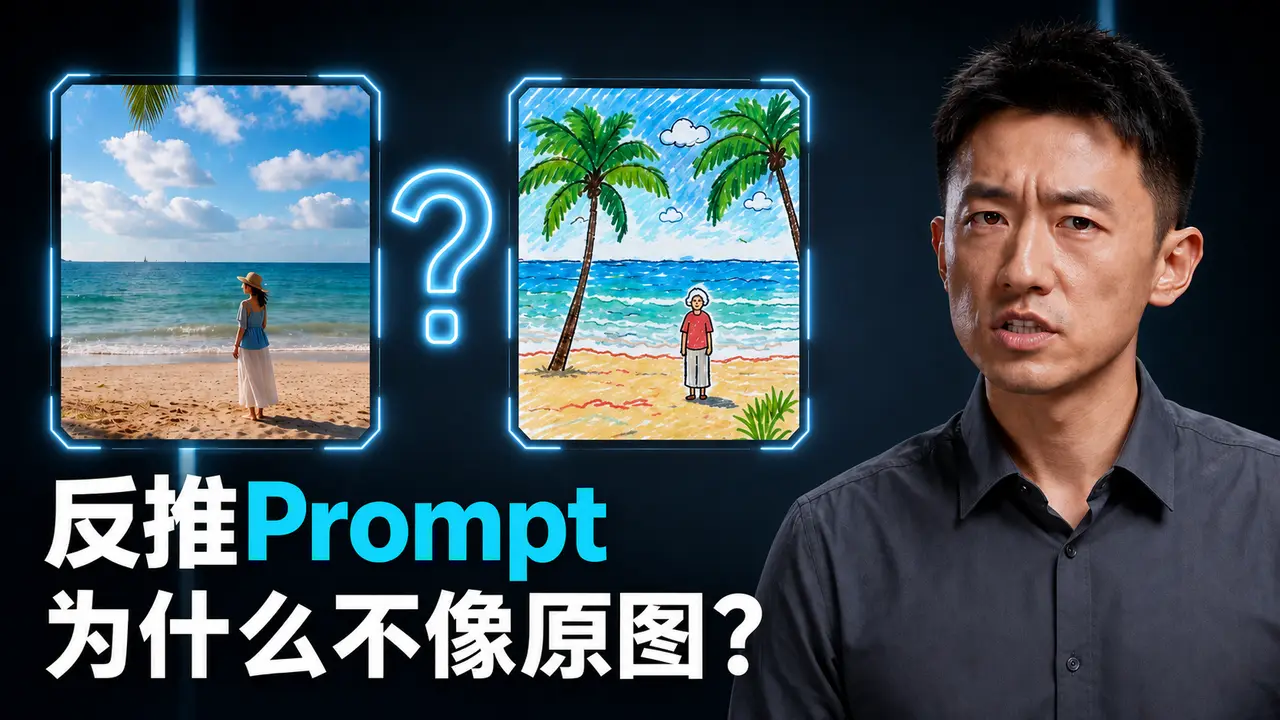
SD2.5实测:反推Prompt为什么复刻不像原图?
【生成内容】 生成一条总时长30秒、16:9横屏的中文AI知识教学视频。 视频标题为:《为什么反推图片 Prompt 生成出来的图不像原图?》 整体是一条具有专业知识博主气质的横屏教学视频,由真人感AI讲师出镜讲解,并穿插高级MG动态图形、动态图解、写实微缩场景和视觉化比喻。视频不是动画片,也不是廉价的卡通科普风格,而是真人实拍质感与高端科技媒体动态图形结合的现代知识栏目风格。整体观感应当聪明、克制、生动、有思考感,既容易理解,又具有专业制作水准。 【AI讲师形象】 固定使用同一位年轻中国男性知识讲师,年龄约30岁,黑色短发,发型干净自然,面部轮廓清晰但不过度精致,保留真实皮肤纹理、细微毛孔和自然的面部不对称感。穿深灰色简洁衬衫或质感良好的深色针织上衣,不出现明显品牌标识,佩戴一枚小型黑色领夹麦克风。 他不是夸张吵闹的娱乐主播,而是一位真正理解AI技术、善于用生活化比喻解释复杂问题的科技知识讲师。他身上具有理性、温和、敏锐和可信赖的气质,说话自然,有清晰的逻辑,也保留一点轻松的幽默感。 他的眼睛必须明亮、专注、有真实的思考感和交流感。看向镜头时,仿佛真正看见了屏幕前的观众,而不是空洞地注视摄像机。眼神中要有好奇、理解和“我知道你为什么会困惑”的共情感。避免AI人物常见的空洞眼神、僵硬微笑、塑料皮肤和没有灵魂的表情。 人物说话时具有丰富但克制的微表情。提出问题时眉毛自然轻微上扬,眼神带着疑问和吸引力;解释原理时神情认真、清醒,目光稳定;讲到“小明和奶奶”的比喻时,嘴角出现非常轻微的笑意,语气变得亲切、有画面感;最后总结时神情坚定,眼神稍微收紧,语速略微放慢,让核心结论真正落下来。 人物具有自然呼吸、自然眨眼、轻微点头、眉眼变化和细小的身体重心移动。手势必须符合说话逻辑:提出问题时轻轻摊开一只手;解释流程时用手指引导旁边的动态图形;讲述类比时手掌自然展开,像在讲一个故事;最后总结时用一个简洁、确定的手势强调结论。动作不夸张,不连续挥舞双手,不出现僵硬站立、重复动作、奇怪手势或手指畸形。 【人物声音与台词】 使用自然、清晰、有质感的中国普通话男性声音。声音年轻但不过分稚嫩,语气温和、自信、聪明,像一位善于解释复杂概念的科技博主。发音清楚,节奏紧凑但不仓促,句子之间保留自然的呼吸和停顿。 人物出镜时,中文口型必须与台词准确同步;进入MG动画和类比场景时,继续使用同一个讲师的声音作为画外音。整条视频必须保持同一个人的声线、音色、语气和情绪连续性。 严格按照以下台词顺序说话,不增加、删除、重复、改写或打乱内容: “为什么反推图片 Prompt,生成结果却不像原图?三十秒告诉你。” “反推不是读取原始提示词,而是 AI 看图以后,用文字重新描述。” “就像小明把三亚风景讲给奶奶听,奶奶只能根据描述和自己的记忆,脑补出另一个三亚。” “哪怕把照片给她,只要她是重新画,而不是复印,也不可能完全一样。” “记住,反推 Prompt 是 AI 看图后的观后感,不是原图的生成配方。” 【场景与整体氛围】 讲师位于一间现代、克制、高级的科技知识工作室中。空间以深灰、石墨黑、低饱和科技蓝和少量暖白色为主。背景具有适当的空间纵深,但不能杂乱。可以出现虚化的玻璃隔断、极简金属框架、柔和的竖向灯带以及少量科技设备轮廓,但不要出现复杂控制台、炫目的霓虹灯或廉价直播间装饰。 背景保持安静、理性、现代,具有高级科技杂志和专业纪录片的视觉气质。工作室的空气中有非常轻微的层次和景深,但不要漂浮大量粒子,不要赛博朋克,不要过度未来化。 人物采用柔和、真实的电影级布光。面部一侧有柔和主光,另一侧保留轻微自然阴影,皮肤色调健康真实;人物肩部和头发边缘具有克制的轮廓光,使人物从深色背景中自然分离。眼睛中具有真实、细腻的眼神光。不要磨皮过度,不要面部过曝,不要让皮肤像蜡像或塑料。 16:9横屏采用信息型构图。讲师可以自然位于画面左侧或右侧三分之一处,另一侧留给图片对比、流程图和MG动画。人物和图形之间必须形成清晰的视觉关系,避免人物挡住信息,也避免画面出现大面积无意义的空白。 镜头以稳定、克制的中景和中近景为主,搭配非常轻微的电影感推进、横向移动和景深变化。镜头运动要服务于解释,不炫技,不快速摇晃,不频繁变焦。画面的节奏来自人物表达、图形运动和自然转场,而不是依赖混乱剪辑。 【开场视觉】 视频从AI讲师的中近景开始。他直视镜头,眼神中带着一种“这个问题很多人都理解错了”的好奇和洞察感。 讲师提出问题时,镜头缓慢而有力量地向前推进。人物旁边浮现一张质感清晰的“原始图片”。这张图片随后像被复制一样分裂成第二张图片,但第二张图片虽然主题相似,人物长相、物体位置、光影和构图却明显不同。 两张图片在横屏画面中形成清晰对比,中间弹出一个简洁、具有视觉重量的问号。问号不是廉价卡通效果,而是由细线、半透明玻璃材质和柔和蓝白色光晕构成。问号出现时,讲师眉毛自然轻微上扬,并将视线短暂移向两张图片,然后重新看回观众。 画面出现简洁、准确、容易阅读的标题: “为什么不像原图?” 标题采用现代无衬线字体、清晰的字重层级和克制的动态排版。文字快速而平稳地进入画面,不弹跳,不旋转,不使用夸张特效。 【反推Prompt的原理动态图解】 随着讲师解释“反推不是读取原始提示词”,旁边的原始图片进入一个透明的AI视觉识别界面。 一道细腻的蓝白色扫描光从图片上方缓慢扫过。扫描经过人物、背景、颜色和构图时,画面中浮现几个简洁的视觉识别标记:人物轮廓框、场景识别框、颜色采样点、构图辅助线和光影方向箭头。 这些识别标记随后被压缩成少量视觉符号和文字卡片,表现AI只是从图片中提取“它看见了什么”。原图丰富而具体的像素细节,在进入文字描述后逐渐变成更加概括、更加抽象的信息。 画面形成一条清晰的横向流程: “原图”→“AI观察”→“文字描述”→“Prompt” 每个节点之间使用细腻的发光线条和方向箭头连接。信息从原图流向Prompt时,视觉内容明显逐渐减少:精确的人脸、物体位置、色彩层次和光影细节,逐渐被压缩成几个简单的词语和图标。 这段MG动画必须让观众直观感受到“图片信息被压缩成文字描述”,而不是让人误以为AI从图片里找到了隐藏的原始Prompt。 【小明和奶奶的视觉化比喻】 流程图中的“图片卡片”自然放大,转场进入一个具有高级广告质感的写实微缩场景。 画面出现阳光下的三亚海边:真实细腻的海浪、金色沙滩、椰树、远处建筑和温暖夕阳。小明站在海边观察风景。这个场景具有真实摄影质感,但以精致微缩沙盘和信息图结合的方式呈现,不是儿童动画,不是卡通人物。 当小明回家向奶奶描述时,椰树、海浪、太阳、沙滩和建筑被转化成简洁、高级的立体信息图标。这些图标沿着一条柔和的动态路径,从小明所在的位置传递到奶奶面前。 信息在传递过程中逐渐丢失细节:椰树的数量减少,夕阳的位置发生变化,海水颜色被简化,建筑轮廓变得模糊。部分图标在移动中轻微淡出,表现语言无法保存原始画面的全部信息。 奶奶认真听着,眼神中带着理解和回忆。她头顶形成一个半透明的思维画面。这个思维画面不是原来的三亚,而是由她自己的记忆重新组合出来的另一片海滩:椰树换了位置,夕阳颜色不同,沙滩弧度改变,远处建筑也不一样。 原来的三亚与奶奶脑补的三亚短暂并排出现。两幅画面主题相同、元素相似,但细节和构图明显不同。通过这种视觉对比,让观众一眼理解:文字传递的是概念,不是完整画面。 【给奶奶看照片的解释】 随后,小明把拍摄的三亚照片直接递给奶奶。奶奶仔细看着照片,开始按照照片重新绘画。 画面使用干净的左右分屏:左侧是原始照片,右侧是奶奶重新画出的风景。奶奶的画保留了海滩、椰树和夕阳等主要内容,但颜色、位置、比例、纹理和细节与照片存在明显差别。 右侧绘画过程体现“参考原图重新创造”,而不是对原图进行像素复制。画面随后短暂出现一台简洁的现代复印机。照片进入复印机后,输出一张完全相同的照片,与奶奶重新绘制的图片形成明确对比。 画面中央出现准确、清晰的短文字: “重新画 ≠ 直接复制” 文字出现时采用平稳、克制的动态排版。等号两侧保持清晰的视觉重量,“≠”符号以轻微亮度变化完成强调,不使用爆炸、抖动或夸张放大。 【结尾总结】 画面通过照片卡片翻转和细腻的whoosh转场,自然回到同一位AI讲师所在的科技工作室。 讲师站在画面一侧,另一侧重新出现完整的信息流程: “原图”→“AI描述”→“重新生成”→“新图片” 原图的信息非常丰富;经过“AI描述”后,细节明显减少;“重新生成”从新的视觉噪声和新的组合开始;最终得到一张主题相似但细节不同的新图片。 讲师说出最后结论时,身体略微前倾,目光稳定地看着观众,语气比前面稍慢、稍坚定。说到“观后感”时,眼神中带有轻微的理解和提醒;说到“不是原图的生成配方”时,用一个简洁的手势完成强调。 最后,其他图形逐渐降低亮度,只保留讲师和核心结论: “反推 Prompt ≠ 原图配方” 结论文字采用现代、干净、专业的中文动态排版。文字清晰稳定地停留在画面安全区域内,给观众留下足够的阅读和理解空间。结尾不要出现关注、点赞、订阅或平台Logo。 【高级MG动态图形风格】 所有MG动画统一采用高级科技媒体、现代数据可视化和编辑设计风格。使用精确的网格系统、整齐的对齐关系、克制的留白、清晰的信息层级和流畅的缓动曲线。 图形语言包含: 半透明玻璃质感的信息面板; 具有轻微空间纵深的2.5D图层; 细腻的发光线条和方向箭头; 简洁的图片卡片和视觉识别框; 柔和但清晰的扫描光; 低饱和科技蓝、暖白色和少量琥珀色强调; 真实而克制的阴影、景深和边缘高光; 自然的淡入、滑动、折叠、缩放和匹配转场。 所有动画必须具有真实的惯性和重量感。元素启动时自然加速,停止时柔和减速;图片卡片移动时带有轻微空间透视;箭头生长时沿路径平滑延伸;信息被压缩时使用逐层收拢、淡出和重组,而不是简单消失。 MG图形需要与讲师的视线和手势发生关系。讲师看向某个图形时,图形才自然出现;讲师伸手指向流程时,箭头沿着手势方向延伸;讲师回看镜头后,次要图形降低亮度,使观众注意力重新回到人物。 不要使用廉价模板动画、夸张弹跳、彩虹渐变、卡通贴纸、漫画爆炸框、大量粒子、随机光效或短视频综艺花字。动态图形必须像专业科技纪录片、设计媒体栏目和高端品牌解释视频,而不是儿童科普动画。 【声音与音效】 No BGM。整条视频完全不使用背景音乐,不生成旋律、鼓点、节拍、氛围音乐或片尾音乐。 声音空间保持干净、安静,让人物声音成为绝对主体。保留极其轻微、自然的室内空间感,但不要明显混响,不要出现嘈杂环境声。 可以使用以下精细音效: 图片进入AI识别界面时,加入轻微、干净的电子扫描声; 扫描线经过图片时,加入非常细腻的高频电子移动声; 箭头和信息路径延伸时,加入柔和、短促的whoosh转场声; 图片卡片放大、翻转和分屏时,加入轻柔的空气切换声; 信息图标从小明传递到奶奶时,加入微弱、清晰的提示音; 部分信息消失时,加入非常轻的淡出声; 问号和核心结论出现时,加入克制、清脆、有质感的提示音; 照片进入复印机时,加入短暂、真实但不过响的纸张和机械扫描声。 所有音效必须与对应画面动作准确同步。音效音量始终低于人物声音,不能遮挡台词,不能连续堆叠,不能产生游戏界面或廉价短视频音效感。 【文字限制】 画面中只允许出现以下指定文字: “为什么不像原图?” “原图” “AI观察” “文字描述” “Prompt” “重新画 ≠ 直接复制” “AI描述” “重新生成” “新图片” “反推 Prompt ≠ 原图配方” 所有文字必须是准确、清晰、可阅读的简体中文或指定英文单词。不要生成其他字幕,不要自动添加逐字字幕,不要出现乱码、错误汉字、无意义英文字母、时间码、水印、平台Logo或软件界面。 【严格一致性要求】 同一AI讲师的脸型、五官、发型、肤色、年龄、身材、服装和领夹麦克风必须全程保持一致。 同一讲师的声音、音色、普通话口音、说话习惯和情绪逻辑必须保持一致。 人物必须有真实的眼神、自然的微表情和准确的中文口型,避免空洞凝视、僵硬微笑、嘴唇乱动、表情突然改变或说话时面部变形。 避免人物变脸、年龄变化、服装变化、肤色变化、发型变化、五官漂移、手指畸形、重复肢体、身体穿模和不自然眨眼。 镜头之间保持统一的工作室空间、光线方向、色彩风格、人物位置逻辑和视觉质感。 不要出现与教学无关的人物、物体和装饰。除小明与奶奶的类比场景外,不增加其他角色。 整个视频必须具有完整、连贯、自然的叙事逻辑:提出问题、解释反推原理、使用生活化比喻、解释图片参考为什么仍不能完全复刻,最后给出明确结论。