
创意一乱,我就想拉。
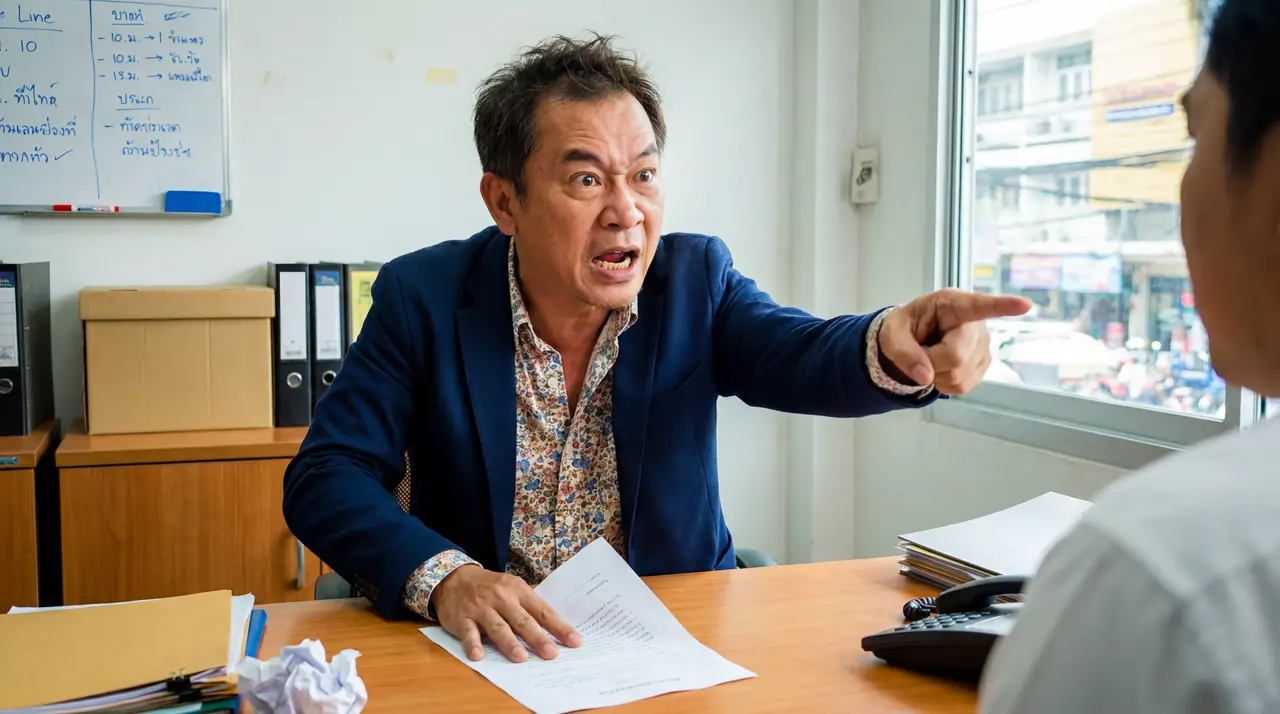 图片节点 5
泰式喜剧广告角色定妆照,16:9横屏,4K UHD,真人写实。 主体:40岁左右亚洲男性老板,短发,穿花衬衫外搭西装外套或亮色商务衬衫,手里拿一张皱巴巴需求单。表情认真到荒唐,眉毛高挑,嘴巴张开像正在宣布不可能任务。 姿态:身体前倾,右手把需求单拍向桌面,左手指向创作者。动作夸张,有喜剧冲击。 光线:明亮办公室光,轻微硬光制造喜剧感。 构图:半身中景,人物偏画面左侧,右侧留主角反应空间。 风格:泰式神广告,节奏夸张,真实人物,色彩鲜明。 负面限制:不要反派黑帮,不要暴力威胁,不要豪华办公室,不要随机中文。
提取出人物脸部特写三视图
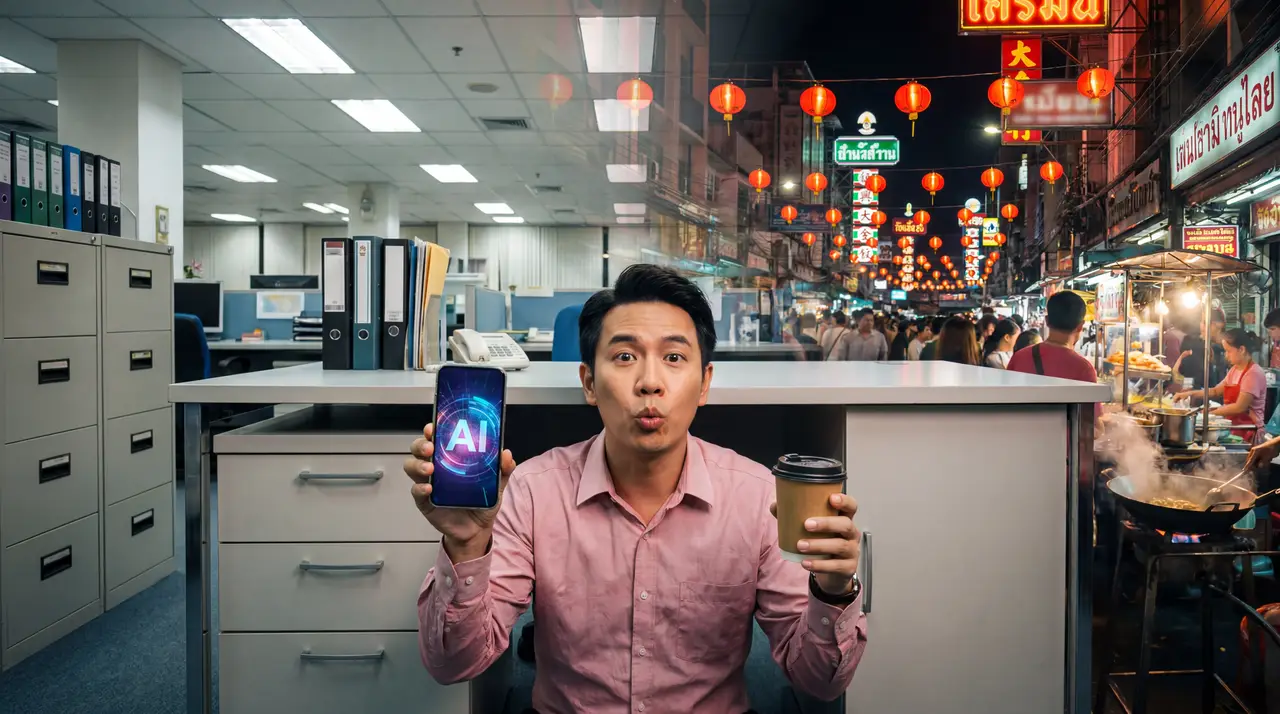 图片节点 7
泰式喜剧广告角色定妆照,16:9横屏,4K UHD。 主体:亚洲客户代表,35岁左右,穿粉色或白色商务衬衫,手拿手机和咖啡,从桌子底下或画面下方探头出现。表情真诚但提出离谱要求。 姿态:上半身从桌底钻出来,抬头看镜头,嘴型像在问“能不能更AI一点”。喜剧荒诞但不低俗。 背景:办公室和脑内夜市混合,空间错位。 风格:泰式广告喜剧,真人写实,夸张构图。 负面限制:不要爬行动物姿态,不要恐怖,不要冒犯,不要随机文字。
泰式喜剧广告办公室场景,16:9横屏,4K UHD,无人物。 空间:小型创意公司办公室,桌面有电脑、便签、咖啡杯、线缆、几张需求纸,墙上有空白白板和便利贴。空间略挤但明亮,不高端。 方位:前景是主角工位,中部电脑屏幕,左侧留老板冲入空间,右侧留字幕和反应空间。 光线:白天自然光、荧光灯和电脑冷光混合,色彩明亮。 风格:真实办公室 + 泰式喜剧广告,轻微广角。 负面限制:不要豪华办公室,不要真实品牌logo,不要随机文字,不要人物。
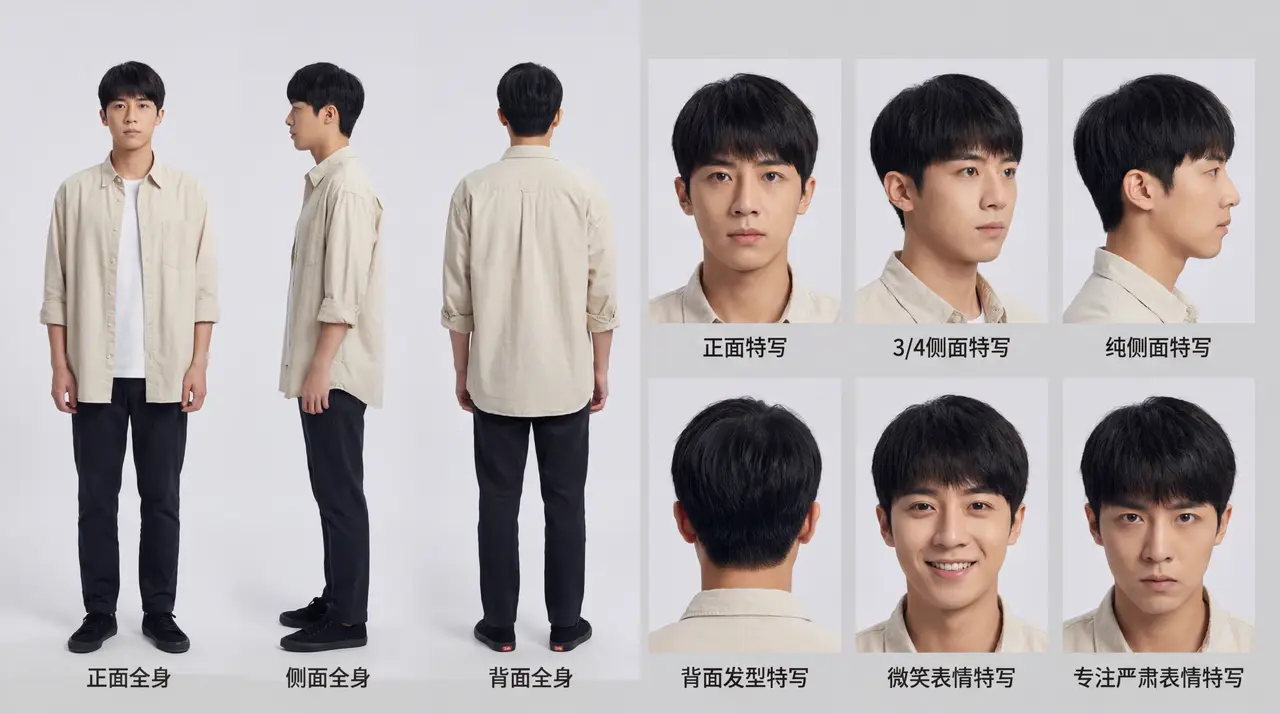 图片节点 13
{{SlashPreset:character_turnaround_3view}}提取出 {{Image 1}} 人物的三视图;写实摄影
AI 创作者工作台画布概念图,16:9 横屏,4K UHD,抽象但可信,不使用真实软件截图。 画面:一个干净的无限画布式 AI 创作工作台,包含空白节点卡片、连接线、素材缩略图色块、轻量时间线和预览窗口。节点按照脚本、分镜、角色、视频的逻辑排列,但卡片上不要生成可读文字,文字后期叠加。 产品感:看起来像创作者工作台,不像播放器,不像普通剪辑软件首页。强调画布、节点、工作流整理、素材被吸附入列。 构图:横屏,左侧是节点画布,右侧是预览窗口,下方有轻量时间线,中央或右上预留品牌落版空间。 光线:屏幕光清晰,周围环境略暗,突出界面秩序感。 风格:现代 AI 创作工具,清楚、专业、可控,但保留一点泰式广告鲜艳边缘光。 负面限制:不要真实软件截图,不要复杂到看不懂,不要随机乱码,不要过度科幻蓝光,不要视频播放平台样式,不要官方未确认 UI 细节。
【输入指令】 根据图片创建剧本 生成提示词 【生成内容】 好的,这是一份根据您提供的图片(一张纯白色背景)创作的剧本。 --- ### 剧本:《空白》 **类型**: 现代 / 心理 / 惊悚 **时长**: 5分钟 **场景**: 一个极其简约、空旷的房间(或一个巨大的、无边无际的白色空间) #### 人物: - **艾拉 (Ella)**: 一位年轻女性,眼神中带着一丝不安和迷茫。 - **声音 (Voice)**: 一个低沉、平静、仿佛来自内心深处的声音。 --- #### 场景一: 空间 - 日 **(画面开始于一片纯粹的、刺眼的白色。没有墙壁,没有地板,没有天花板,只有无尽的、均匀的白。镜头缓缓推进,仿佛在穿越一片白色的雾气。突然,一个身影出现在画面中央——艾拉。她穿着简单的白色连衣裙,与周围环境融为一体,显得既突兀又和谐。她的表情是平静的,但眼神深处藏着一丝不易察觉的恐惧。她环顾四周,试图寻找什么,但除了白色,什么也看不到。)** **艾拉** (低声,自言自语) 这里... 是哪里?... 我怎么会在这里? **(她伸出手,触摸空气,仿佛在确认它的存在。她的手指穿过空气,没有任何感觉。她低头看向自己的手,然后猛地抬头,似乎听到了什么。)** **声音** (从四面八方传来,平静而清晰) 你终于来了,艾拉。 **艾拉** (惊恐地后退一步,声音颤抖) 谁?!谁在说话?! **声音** 别害怕。我就是你。你一直在找的答案,就在你心里。 **(艾拉紧紧抓住自己的头,痛苦地闭上眼睛。)** **艾拉** 不... 不要... 我不想知道... **声音** 你必须知道。你无法逃避。看看你的手。 **(艾拉颤抖着睁开眼,低头看向自己的手。她的皮肤开始变得透明,可以看到里面的血管和骨骼。她尖叫起来,想要逃离,但发现自己动弹不得。)** **艾拉** 放开我!让我走! **声音** 你走不了的。你一直都在这里。你只是... 忘记了。 **(画面突然剧烈震动,白色空间开始扭曲、崩塌。无数个模糊的、哭泣的人影在白色中浮现,又迅速消失。艾拉的尖叫声被淹没在一片寂静中。)** **(画面陷入黑暗,只有一片死寂。)** **(几秒后,画面重新亮起,依旧是那片纯粹的白色。艾拉站在原地,但她的身体已经完全透明,像一缕烟雾。她茫然地看着自己的手,然后抬起头,脸上露出一种诡异的、平静的微笑。)** **艾拉** (轻声,仿佛在说给自己听) 原来... 这里... 就是我。 **(画面定格在艾拉那张平静的、半透明的脸庞上,然后缓缓淡出至全白。)** **(黑屏。字幕出现:)** **“我们总是在寻找答案,却忘了答案就在我们自己心中。”** **(剧终)**
 视频截图视频节点 9
【基础设定】 视频类型:无完整定帧图,资产输入导演版。 时长:5秒。 本条输入资产: 1. {{Mixed 1}} 2. LTV_脑内夜市剧组_4K_v1.png 可选输入资产:脑内编剧、脑内摄影师、脑内美术、脑内剪辑师、客户的单人资产;只有角色漂移严重时才补充。 禁止输入资产:LTV_LibTV工作台界面_4K_v1.png、LTV_Text_落版_16x9.png。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 此刻只允许出现“脑内混乱”,不能出现解决方案。脑内五个角色可由文本描述生成,不必每人单独上传资产。所有纸张、角色图、手机屏幕都不能出现可读随机文字。客户可以说“更 AI 一点”,但画面不能出现 LibTV 文字。 【叙事前摇】 观众期待创作者只是普通焦虑,结果他的脑子直接变成曼谷夜市剧组。混乱必须先爆满,后面的“拉”才有爽感。 【画面内容】 分镜一:00:05.00-00:06.00 景别:主角特写转场。 构图:主角头顶白烟膨胀,办公室背景被彩色夜市灯吞掉。 运镜手法:快速推近后闪切。 画面内容:白烟“砰”地扩散,主角像被吸进自己的脑内世界。 声音对白环境音:喜剧爆炸气音、短促铜钹声、人群哗然声起;无对白。 分镜二:00:06.00-00:08.80 景别:广角群像。 构图:横屏中间留空,编剧、摄影师、美术、剪辑师从四个方向冲入。 运镜手法:快速横移,轻微手持。 画面内容:编剧挥纸,摄影师扛相机,美术抱角色图,剪辑师拖硬盘线缆,场面乱但每个人动作清楚。 声音对白环境音:画面内-编剧喊:“剧本还没想好!”摄影师接:“镜头还没排好!”美术喊:“角色又变脸了!” 分镜三:00:08.80-00:10.00 景别:低角度中近景。 构图:客户从画面下方桌底探头,其他角色突然回头。 运镜手法:突然定住半拍。 画面内容:客户真诚地举着手机,表情离谱又认真。 声音对白环境音:剪辑师画外喊:“谁删了第七秒!”客户接一句:“能不能更 AI 一点?”随后全场安静半拍。 【声音与对白】 复核:本单元必须吵,但不是乱到听不清。最后客户一句话要形成荒诞停顿。
根据 {{Mixed 1}} 视频中的场景、人物、声音续写; 【基础设定】 视频类型:无完整定帧图 + 文字关键定帧混合。 时长:5秒。 本条输入资产: 1. LTV_创作者阿明_4K_v1.png 2. LTV_脑内夜市剧组_4K_v1.png 3. LTV_拖拽节点动作参考 {{Mixed 2}} 禁止输入资产:LTV_LibTV工作台界面_4K_v1.png、LTV_Text_落版_16x9.png。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 本单元只建立“拉”的动作和前两句副歌。可以出现发光节点,但不能出现完整 LibTV 工作台。副歌字幕后期叠加,不上传字幕图给视频模型。 【叙事前摇】 全场突然安静,观众以为创作者要解释方法。他只问一句“乱?”,然后不讲道理,直接用动作和口号把观众带进节奏。 【画面内容】 分镜一:00:10.00-00:11.00 景别:中景。 构图:主角站在混乱中心,所有脑内角色在周围定格。 运镜手法:突然静止,轻微推近。 画面内容:主角慢慢抬头,表情从崩溃变成顿悟。 声音对白环境音:所有吵闹声瞬间抽掉;画面内-创作者(压低,短促)说:“乱?” 分镜二:00:11.00-00:13.00 景别:正面群像。 构图:全员横向排开,动作对称,画面下方留字幕区。 运镜手法:轻微前推,跟随第一次“拉”动作。 画面内容:全员双手抓住空气中的剧本纸团,往中间一拉,纸团变成发光节点。 声音对白环境音:画面内-全员整齐喊:“不会写?拉!”每个“拉”配弹簧音和节点吸附音。 分镜三:00:13.00-00:15.00 景别:正面群像转局部特写。 构图:摄影师在前景,摄像机旁出现第二个发光节点。 运镜手法:横移半步再定住。 画面内容:全员第二次做“拉”动作,混乱的摄像机和镜头卡片收成节点。 声音对白环境音:画面内-全员喊:“不会拍?拉!”手鼓节奏可作为后期参考,但本条不生成完整背景音乐。 【声音与对白】 复核:本单元必须出现两次“拉”。动作比文字更重要,字幕后期叠加。
根据 {{Mixed 1}} 视频中的场景、人物、声音续写; 【基础设定】 视频类型:无完整定帧图 + 文字关键定帧混合。 时长:5秒。 本条输入资产: 1. LTV_创作者阿明 {{Mixed 3}} 2. LTV_脑内夜市剧组_4K_v1.png 3. LTV_拖拽节点动作参考 {{Mixed 2}} 禁止输入资产:LTV_LibTV工作台界面_4K_v1.png、LTV_Text_落版_16x9.png。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 本单元只建立“拉”的动作和前两句副歌。可以出现发光节点,但不能出现完整 LibTV 工作台。副歌字幕后期叠加,不上传字幕图给视频模型。 【叙事前摇】 全场突然安静,观众以为创作者要解释方法。他只问一句“乱?”,然后不讲道理,直接用动作和口号把观众带进节奏。 【画面内容】 分镜一:00:10.00-00:11.00 景别:中景。 构图:主角站在混乱中心,所有脑内角色在周围定格。 运镜手法:突然静止,轻微推近。 画面内容:主角慢慢抬头,表情从崩溃变成顿悟。 声音对白环境音:所有吵闹声瞬间抽掉;画面内-创作者(压低,短促)说:“乱?” 分镜二:00:11.00-00:13.00 景别:正面群像。 构图:全员横向排开,动作对称,画面下方留字幕区。 运镜手法:轻微前推,跟随第一次“拉”动作。 画面内容:全员双手抓住空气中的剧本纸团,往中间一拉,纸团变成发光节点。 声音对白环境音:画面内-全员整齐喊:“不会写?拉!”每个“拉”配弹簧音和节点吸附音。 分镜三:00:13.00-00:15.00 景别:正面群像转局部特写。 构图:摄影师在前景,摄像机旁出现第二个发光节点。 运镜手法:横移半步再定住。 画面内容:全员第二次做“拉”动作,混乱的摄像机和镜头卡片收成节点。 声音对白环境音:画面内-全员喊:“不会拍?拉!”手鼓节奏可作为后期参考,但本条不生成完整背景音乐。 【声音与对白】 复核:本单元必须出现两次“拉”。动作比文字更重要,字幕后期叠加。
 视频截图视频节点 9
根据 {{Mixed 1}} 视频中的场景、人物、声音续写; 【基础设定】 视频类型:无完整定帧图,资产输入导演版。 时长:5秒。 本条输入资产: 1. LTV_创作者阿明_4K_v1.png 2. LTV_脑内夜市剧组_4K_v1.png 可选输入资产:脑内编剧、脑内摄影师、脑内美术、脑内剪辑师、客户的单人资产;只有角色漂移严重时才补充。 禁止输入资产:LTV_LibTV工作台界面_4K_v1.png、LTV_Text_落版_16x9.png。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 此刻只允许出现“脑内混乱”,不能出现解决方案。脑内五个角色可由文本描述生成,不必每人单独上传资产。所有纸张、角色图、手机屏幕都不能出现可读随机文字。客户可以说“更 AI 一点”,但画面不能出现 LibTV 文字。 【叙事前摇】 观众期待创作者只是普通焦虑,结果他的脑子直接变成曼谷夜市剧组。混乱必须先爆满,后面的“拉”才有爽感。 【画面内容】 分镜一:00:05.00-00:06.00 景别:主角特写转场。 构图:主角头顶白烟膨胀,办公室背景被彩色夜市灯吞掉。 运镜手法:快速推近后闪切。 画面内容:白烟“砰”地扩散,主角像被吸进自己的脑内世界。 声音对白环境音:喜剧爆炸气音、短促铜钹声、人群哗然声起;无对白。 分镜二:00:06.00-00:08.80 景别:广角群像。 构图:横屏中间留空,编剧、摄影师、美术、剪辑师从四个方向冲入。 运镜手法:快速横移,轻微手持。 画面内容:编剧挥纸,摄影师扛相机,美术抱角色图,剪辑师拖硬盘线缆,场面乱但每个人动作清楚。 声音对白环境音:画面内-编剧喊:“剧本还没想好!”摄影师接:“镜头还没排好!”美术喊:“角色又变脸了!” 分镜三:00:08.80-00:10.00 景别:低角度中近景。 构图:客户从画面下方桌底探头,其他角色突然回头。 运镜手法:突然定住半拍。 画面内容:客户真诚地举着手机,表情离谱又认真。 声音对白环境音:剪辑师画外喊:“谁删了第七秒!”客户接一句:“能不能更 AI 一点?”随后全场安静半拍。 【声音与对白】 复核:本单元必须吵,但不是乱到听不清。最后客户一句话要形成荒诞停顿。
【基础设定】 视频类型:无完整定帧图 + 界面关键布局混合。 时长:9秒。 本条输入资产: 1. {{Mixed 2}} 2. {{Mixed 2}} 3. {{Mixed 1}} 禁止输入资产:LTV_Text_落版_16x9.png、老板震惊镜头、全员贴脸合唱、新增 UI 文字整板。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 这是第一次正式展示产品能力。界面只表现“AI 创作者工作台 / 无限画布 / 节点式流程”的概念,不冒充真实后台截图。节点布局由 `LTV_LibTV工作台界面_4K_v1.png` 与文字描述控制,不再额外做组合布局图;节点文字“剧本、分镜、角色、视频、修改”必须后期叠加或文字关键帧兜底。 【叙事前摇】 前面多次“拉”只看到节点被抽出来,观众还不知道拉到哪里。本单元揭示:它们不是消失,而是进入 LibTV 工作台,被整理成流程。音乐也从“喊口号”变成“功能收编口诀”。 【画面内容】 分镜一:00:30.00-00:32.50 景别:电脑屏幕中近景。 构图:屏幕占画面右侧三分之二,左侧可见主角侧脸和手。 运镜手法:从主角肩后推向屏幕。 画面内容:脑内夜市的发光节点从画面左侧飞入电脑屏幕,进入 LibTV 工作台画布。 声音对白环境音:夜市混乱声被吸入屏幕,转成清脆 UI 吸附声;无对白。 分镜二:00:32.50-00:36.50 景别:屏幕特写。 构图:画布居中,下方时间线,右侧预览窗口。 运镜手法:稳定推近,节点吸附时轻微节奏跳切。 画面内容:节点依次排列为剧本、分镜、角色、视频、修改;连接线出现,时间线自动整齐,预览窗口亮起。 声音对白环境音:节点吸附声连续五次,分别对应五个节点;画面外群像轻声节奏念:“剧本来,分镜来,角色视频排一排。”不生成自动字幕。 分镜三:00:36.50-00:39.00 景别:主角中近景。 构图:主角脸在左,清楚工作台界面在右后方。 运镜手法:轻微回拉。 画面内容:主角看着界面松一口气,眼神从崩溃变成“有救了”。 声音对白环境音:主角很轻地呼出一口气,界面音停在清脆完成声。画面外群像补一句:“修改也别乱来,拉进 LibTV!”后期字幕可叠加:“一张画布,拉成工作流。” 【声音与对白】 复核:本单元无口播对白。必须让观众看懂 LibTV 是工作台,不是播放器。
【基础设定】 视频类型:无完整定帧图,资产输入导演版。 时长:5秒。 本条输入资产: 1. LTV_创作者阿明_4K_v1.png 2. LTV_老板_4K_v1.png 3. LTV_小办公室_4K_v1.png 禁止输入资产:LTV_脑内夜市剧组_4K_v1.png、全部脑内剧组角色、LTV_LibTV工作台界面_4K_v1.png、全部文字落版。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 此刻只发生办公室急单。观众还不能看见脑内夜市,也不能知道 LibTV 是解决方案。需求单作为画面内一次性道具由模型按描述生成即可,不单独做资产图;纸面文字建议后期叠加,不让模型自由生成中文。 【叙事前摇】 先让观众看见创作者已经快下班:咖啡见底、眼神放空。前摇期待是“今天终于结束了”,落差是老板突然拍桌,抛出不可能任务。 【画面内容】 分镜一:00:00-00:01.20 景别:办公室中景。 构图:创作者坐在画面中部偏右,电脑屏幕在右侧,左侧留出老板入画空间。 运镜手法:固定机位,轻微办公纪录感。 画面内容:创作者盯着电脑,眼神放空,手边咖啡杯见底,肩膀塌着。 声音对白环境音:键盘零星声、空调声、远处办公室低噪;无对白。 分镜二:00:01.20-00:02.70 景别:中近景。 构图:老板从画面左侧冲入,手掌和需求单进入前景。 运镜手法:拍桌瞬间镜头轻微震动。 画面内容:老板把皱巴巴需求单啪地拍在桌上,咖啡杯和便签震一下。 声音对白环境音:老板拍桌声很响;画面内-老板(连珠炮,荒诞严肃)说:“明天要一条 AI 广告!” 分镜三:00:02.70-00:05.00 景别:主角近景。 构图:创作者脸部占画面中心,老板在后方虚焦,需求单在前景边缘。 运镜手法:快速推近到主角脸。 画面内容:创作者眼睛睁大,嘴角僵住,头顶冒出喜剧化白烟。 声音对白环境音:画面内-老板继续说:“泰式!洗脑!高级!还要便宜!”创作者不说话,只吸一口冷气。 【声音与对白】 复核:本单元只有老板一段连珠炮台词。不要出现 LibTV,不要出现脑内夜市。
根据 {{Mixed 1}} 视频中的场景、人物、声音续写;【基础设定】 视频类型:无完整定帧图 + 文字关键定帧混合。 时长:7秒。 本条输入资产: 1. LTV_脑内夜市剧组_4K_v1.png 2. LTV_拖拽节点动作参考 {{Mixed 2}} 可选输入资产:LTV_脑内剪辑师_4K_v1.png、LTV_客户_4K_v1.png;只有角色漂移严重时才补充。 禁止输入资产:LTV_Text_落版_16x9.png、完整品牌落版、新增未设定角色。 声音限制:只按分镜内声音执行;无背景音乐;无旁白;不要模型自动生成字幕。 【资产逻辑自检】 本单元继续副歌,但仍不能完整落版。剪辑师和客户可以按文字描述生成,不默认上传单人资产。可以让节点开始朝屏幕方向飞,但不能把完整工作台流程提前展示完。 【叙事前摇】 观众已经学会“不会 X?拉!”的句式。本单元要让他们预判成功:剪辑来了,拉;客户改稿来了,也拉。随后追加第二个魔性短句“乱乱乱、散散散、拖一拖、拉一拉”,让音乐更上头。 【画面内容】 分镜一:00:23.00-00:25.00 景别:运动中景。 构图:剪辑师从左向右跑,线缆拖在后方,全员在背景准备动作。 运镜手法:快速跟拍再急停。 画面内容:剪辑师抱着素材箱惊慌冲过,全员同时伸手一拉,散乱片段变成“视频节点”的抽象发光卡片。 声音对白环境音:画面内-全员喊:“不会剪?拉!”硬盘碰撞声、节点吸附音。 分镜二:00:25.00-00:27.00 景别:中近景。 构图:客户从画面下方探头,手机和修改意见在前景,其他人围成半圆。 运镜手法:轻微低角度推近。 画面内容:客户举手要说话,全员不等他说完,做第四次“拉”,客户身边的修改便签收成“修改节点”。 声音对白环境音:客户刚开口“能不能再...”被全员口号盖过:“不会改?拉!” 分镜三:00:27.00-00:30.00 景别:发光节点中景。 构图:四个节点从脑内夜市场景飞向画面右侧,像要进入电脑屏幕。 运镜手法:节点飞行方向轻微跟随。 画面内容:夜市混乱声被节点吸走,角色动作从乱跑变成整齐停住。全员像跳广告舞一样做四拍动作:指脑袋、指散乱素材、往屏幕方向拖、往画布里拉。 声音对白环境音:画面内-全员节奏喊:“乱乱乱!散散散!拖一拖!拉一拉!”最后“拉一拉”接连续 UI 吸附预备音。 【声音与对白】 复核:本单元是口号强化,不讲产品说明。剪辑与修改两个痛点必须清楚,“乱乱乱、散散散、拖一拖、拉一拉”要和动作精准对应。
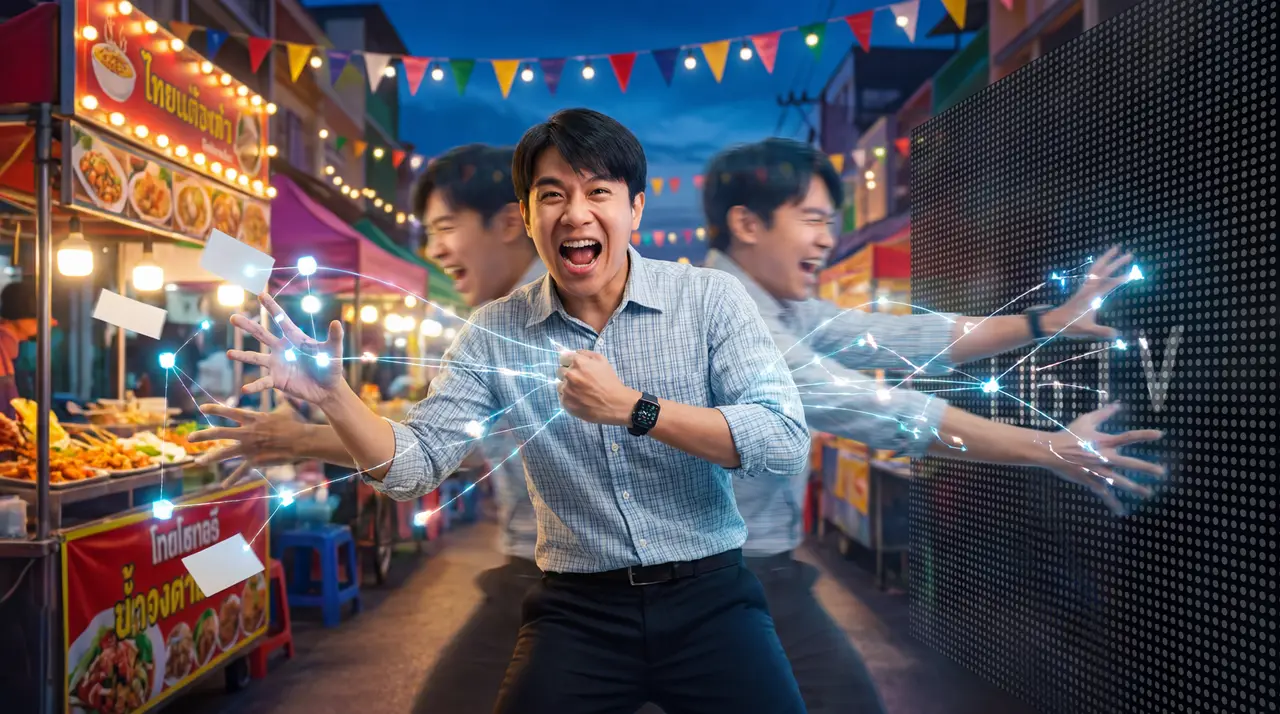 图片节点 14
16:9 横屏动作参考,4K UHD,泰式洗脑广告 MV 动作定格。 主体:同一个亚洲男性创作者站在画面中央,做连续拖拽节点动作的三段式姿态:双手向外抓住空气中的发光节点、往胸前一收、往右侧 LibTV 画布方向一拉。可以用三个半透明残影展示动作过程。 表情:夸张快乐,像强拍上喊“拉!”,但不是完整唱歌。 节点:空气中有发光圆点、连接线和空白卡片,被手势拉动,产生吸附感。 背景:彩色脑内夜市舞台和半透明 LibTV 暗色点阵工作台画布融合。 风格:泰式神广告,动作清楚,节奏感强,真人写实,轻微运动模糊。 负面限制:不要文字,不要 logo,不要多余人物抢主体,不要魔法宗教感,不要恐怖光效。
泰式洗脑广告脑内合唱队,16:9 横屏,4K UHD,真人写实广告质感。 主体:3到5个亚洲广告角色站在脑内夜市舞台后方,包含一位女性领唱和两到三位男女合唱队员。女性领唱拿复古小喇叭或手持麦克风,男声队员做强拍回应动作。 表演:他们像画外广告声的可视化,不抢男主。表情夸张快乐,准备喊短促口号“拉!”、“LibTV!”。不要让他们完整演唱所有歌词。 构图:合唱队在中后景,中央前方留给男主做拖拽动作。 风格:泰式街头叫卖感、洗脑广告 MV、热闹但干净。 负面限制:不要真实泰文,不要宗教服饰,不要恐怖妆容,不要拥挤,不要随机文字。
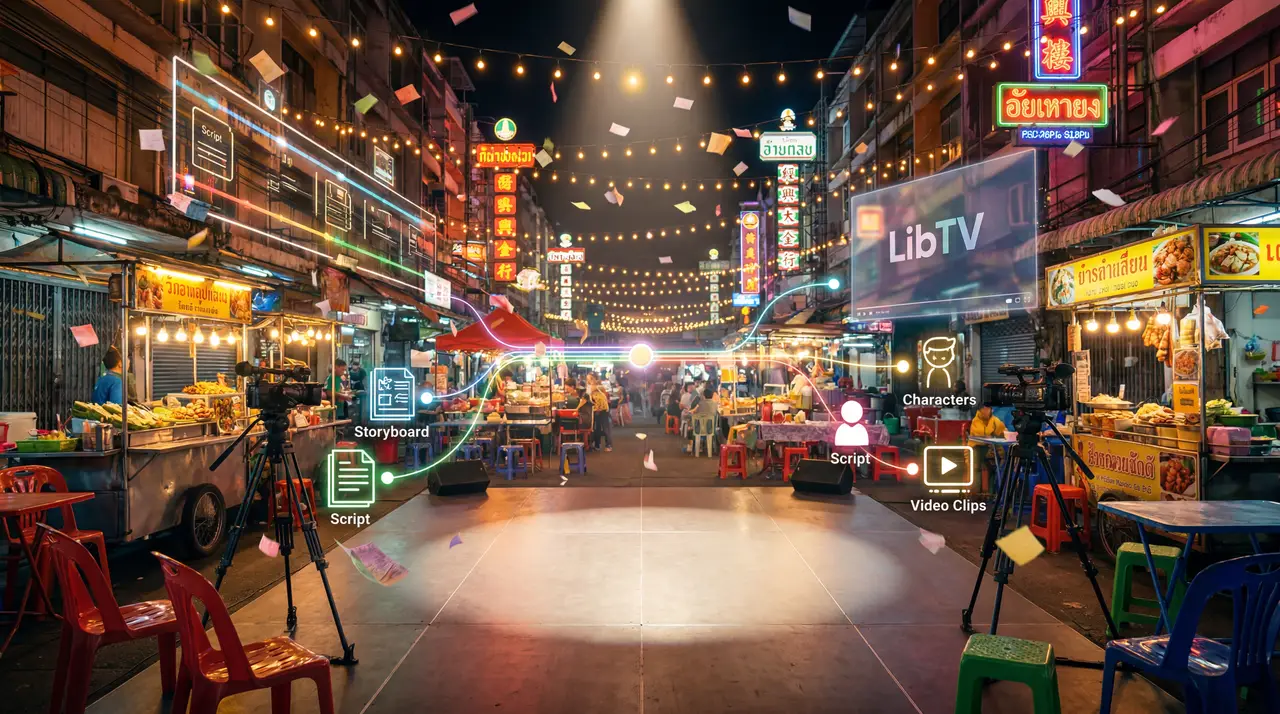 图片节点 7
创作者脑内世界场景,泰式夜市和广告舞台混合,16:9 横屏,4K UHD,无固定人物。 空间:像曼谷夜市一样热闹的脑内广告舞台,彩色灯串、摊位灯、塑料椅、道具箱、摄像机三脚架、飞散纸张、抽象时间线装置。整体荒诞、快乐、洗脑,但画面干净。 核心视觉:中央有一块空地,适合主角做拖拽节点动作;左右两侧可以安排脚本、分镜、角色、素材等图形节点飞入。 光线:暖色摊位灯、彩色霓虹、局部舞台追光,饱和但不脏。 构图:中间留表演空间,右侧远处可预留半透明 LibTV 画布方向。 风格:泰式神广告、喜剧、热闹、真人广告质感,轻微广角,浅景深。 负面限制:不要宗教寺庙符号,不要真实泰文乱码,不要恐怖夜市,不要拥挤到看不清动作,不要随机中文。
超清重绘细节;场景细节、人物细节、服装、道具、脸部特征等等。超清重绘
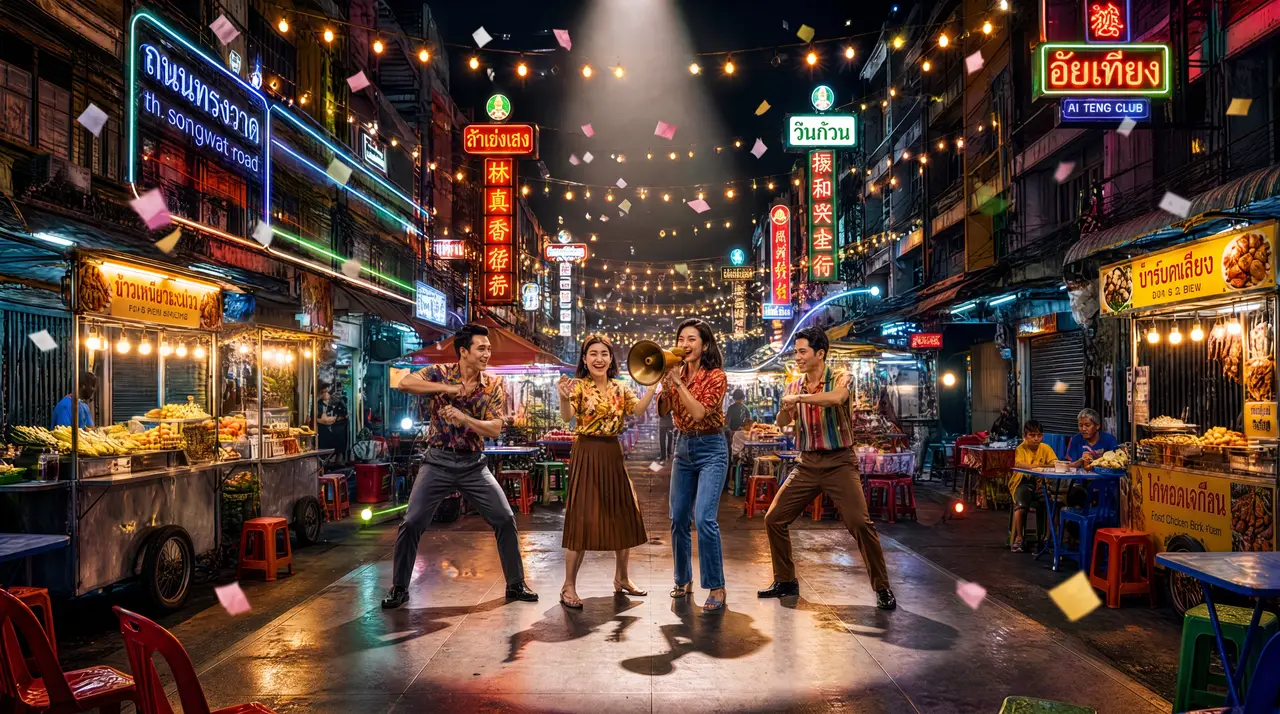 图片节点 21
超清重绘细节;场景细节、人物细节、服装、道具、脸部特征等等。超清重绘;去除脏感、颗粒感、噪点等。干净的画面
超清修复提取出画面中人物的脸部特写
超清重绘细节;场景细节、人物细节、服装、道具、脸部特征等等。超清重绘;干净的画面;
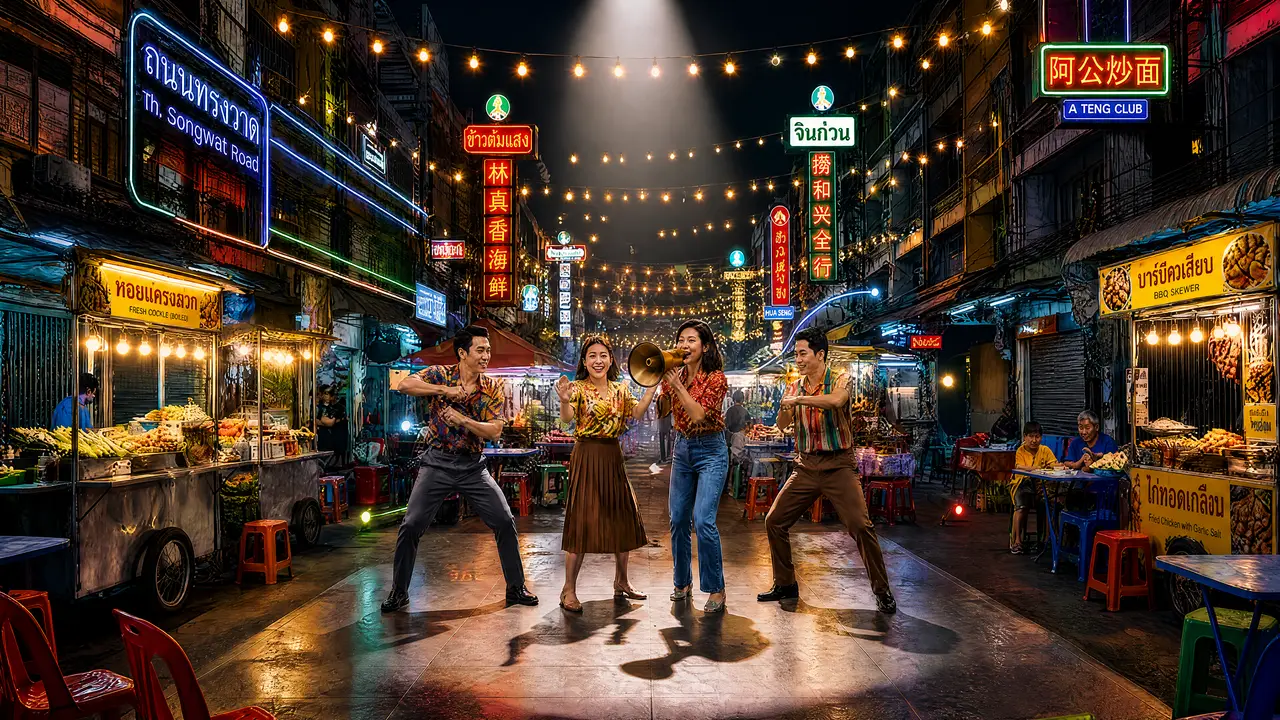 图片节点 25
超清修复提取出画面中场景,并修复文字细节、场景细节;不要运动模糊 不要低清颗粒
泰式洗脑广告脑内合唱队,16:9 横屏,4K UHD,真人写实广告质感。 主体:3到5个亚洲广告角色站在脑内夜市舞台后方,包含一位女性领唱和两到三位男女合唱队员。女性领唱拿复古小喇叭或手持麦克风,男声队员做强拍回应动作。 表演:他们像画外广告声的可视化,不抢男主。表情夸张快乐,准备喊短促口号;不要让他们完整演唱所有歌词。 构图:合唱队在中后景,中央前方留给男主做拖拽动作。 风格:泰式街头叫卖感、洗脑广告 MV、热闹但干净。 负面限制:不要真实泰文,不要宗教服饰,不要恐怖妆容,不要拥挤,不要随机文字。
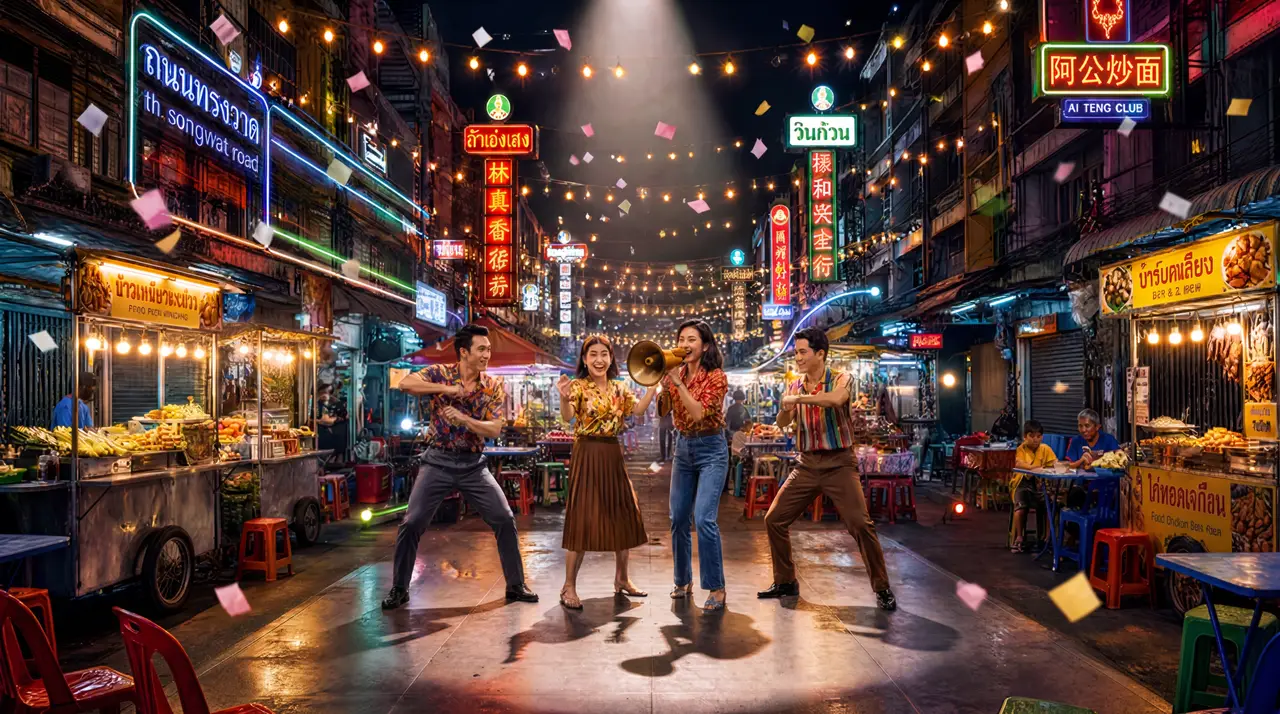 图片节点 24
超清修复图1的场景和人物
16:9 横屏动作参考,4K UHD,泰式洗脑广告 MV 动作定格。 主体:同一个亚洲男性创作者站在画面中央,做连续拖拽节点动作的三段式姿态:双手向外抓住空气中的发光节点、往胸前一收、往右侧 LibTV 画布方向一拉。可以用三个半透明残影展示动作过程。 表情:夸张快乐,像强拍上喊“拉!”,但不是完整唱歌。 节点:空气中有发光圆点、连接线和空白卡片,被手势拉动,产生吸附感。 背景:彩色脑内夜市舞台和半透明工作台画布融合。 风格:泰式神广告,动作清楚,节奏感强,真人写实,轻微运动模糊。 负面限制:不要文字,不要 logo,不要多余人物抢主体,不要魔法宗教感,不要恐怖光效。
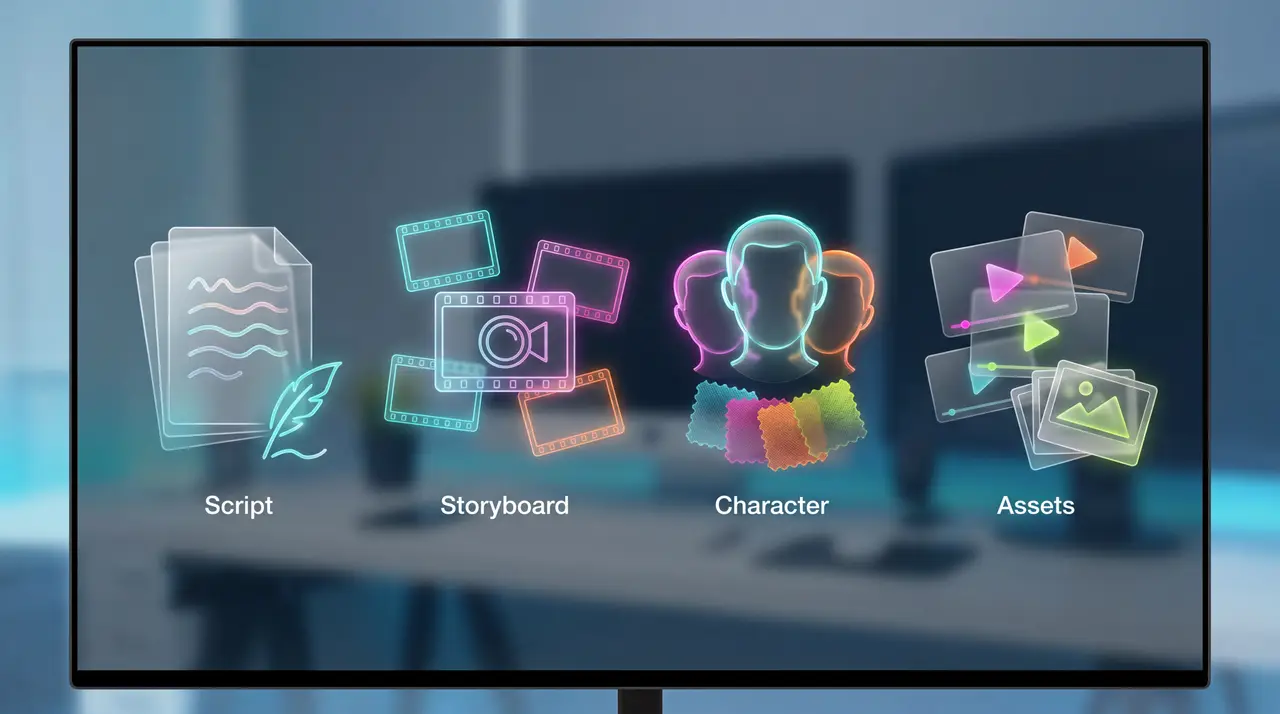 图片节点 15
AI 创作流程节点素材组,16:9 横屏,4K UHD,透明感图形资产风格。 画面:四组空白节点卡片和图形符号,分别代表脚本、分镜、角色、素材。脚本用纸张和段落线图形,分镜用小画框和镜头图标,角色用头像轮廓和服装色块,素材用视频缩略图和图片卡片。所有卡片不要出现可读文字。 构图:四组节点从左到右排列,但有一点飞散动态,方便视频里被主角拉进工作台。 风格:现代 AI 工作台图形 + 泰式广告鲜艳色彩点缀,干净、清楚、可识别。 负面限制:不要真实文字,不要乱码,不要真实软件 UI,不要品牌 logo,不要复杂到看不清类别。
泰式喜剧广告里的小型创作办公室,16:9 横屏,4K UHD,无人物。 空间:小型 AI 创作者工位,桌面有电脑、鼠标、耳机、咖啡杯、便签、空白卡片、素材缩略图色块、线缆。空间略挤但明亮,不高端。 核心视觉:桌面和墙面有很多空白灵感卡、流程线、节点贴纸,表现点子太多和流程太乱,但不要出现可读中文。 方位:画面中部是主角座位,右侧留电脑屏幕和 LibTV 画布方向,左侧留乱飞卡片进入空间。 光线:白天自然光、荧光灯和电脑冷光混合,整体清楚明亮。 风格:真实办公室 + 泰式夸张广告,轻微广角,色彩鲜明。 负面限制:不要豪华办公室,不要老板冲入,不要客户探头,不要真实品牌logo,不要随机文字,不要恐怖杂乱。
 图片节点 13
这是从 LibTV 真实页面截图裁切出来的参考图,不是重新生成图。 裁切保留:暗色点阵无限画布、左侧资产栏局部、中央大 LibTV logo 节点、节点连线、右侧文本节点和图片节点结构。 裁切或遮挡:右上角会员、积分、头像、折扣提示、项目私密信息、可读小字密集区域。 使用方式:在 Seedance 里作为 `@图片` 上传时,只要求模型参考界面风格、空间布局、暗色点阵画布、节点连线和卡片形态,不要求复刻全部文字。 负面限制:不要生成账号信息,不要生成积分数字,不要生成用户头像,不要复刻小字,不要让界面变成视频播放器,不要过度科幻化。
泰式洗脑广告 MV 男主角定妆照,16:9 横屏,4K UHD,真人写实广告质感,表情喜剧化但不低俗。 主体:30岁左右亚洲男性 AI 创作者,短黑发,普通身材,穿浅蓝格子衬衫或白T外搭薄衬衫,脖子挂耳机或工牌。气质是普通创作者,不是明星偶像,不是商务精英。 表情:眼神有点被创意流程搞乱的疲惫感,但很有喜剧反应力。嘴型只适合喊短促口号“拉!”或“LibTV!”,不要像完整演唱一首歌。 姿态:半身中景,双手准备抓住空气中的发光节点,身体微微前倾,像要把混乱灵感拖进电脑画布。 场景:小型创意办公室,电脑屏幕在画面右侧或后方发光,桌上有咖啡、便签、素材卡、鼠标和线缆。 光线:明亮办公室光 + 屏幕冷光,色彩清爽,带一点泰式广告的热闹饱和度。 构图:人物占画面高度约60%,右侧或前方留出发光节点和 LibTV 画布方向。 风格:泰式喜剧广告,真人写实,轻微广角,动作感强,干净不恐怖。 负面限制:不要欧美人脸,不要西装精英,不要老板或客户角色,不要恐怖,不要哭泣,不要随机文字,不要品牌logo,不要让人物完整唱歌。
 图片节点 14
基于 LibTV 真实页面风格的 AI 创作者工作台画布概念图,16:9 横屏,4K UHD,暗色产品界面,不使用账号信息。 画面:深黑色点阵无限画布,左侧有简化资产栏,中间是大号 LibTV logo 节点,右侧有文本节点和图片节点,节点之间用流畅曲线连接。整体参考真实 LibTV 页面截图的空间关系和暗色工作台质感。 产品感:看起来像 AI 创作者工作台,不像视频播放器,不像普通剪辑软件首页。强调画布、节点、工作流整理、素材被吸附入列。 构图:横屏,中央偏左是 LibTV logo 节点,右侧是脚本/图片/视频节点区域,左侧资产栏弱化为结构参考,中央或右侧预留后期品牌落版空间。 光线:屏幕光清晰,暗色背景干净,节点边框和连接线可见。 风格:现代 AI 创作工具,清楚、专业、可控,保留一点泰式广告鲜艳边缘光,但主体仍是 LibTV 真实暗色工作台风格。 负面限制:不要账号信息,不要积分数字,不要用户头像,不要真实小字,不要随机乱码,不要过度科幻蓝光,不要视频播放平台样式。
LibTV泰式洗脑广告海报;不要泰语,可以显示中文;泰式洗脑神曲、LibTV创作者工作台,100%上头!,下方不要其它icon图标
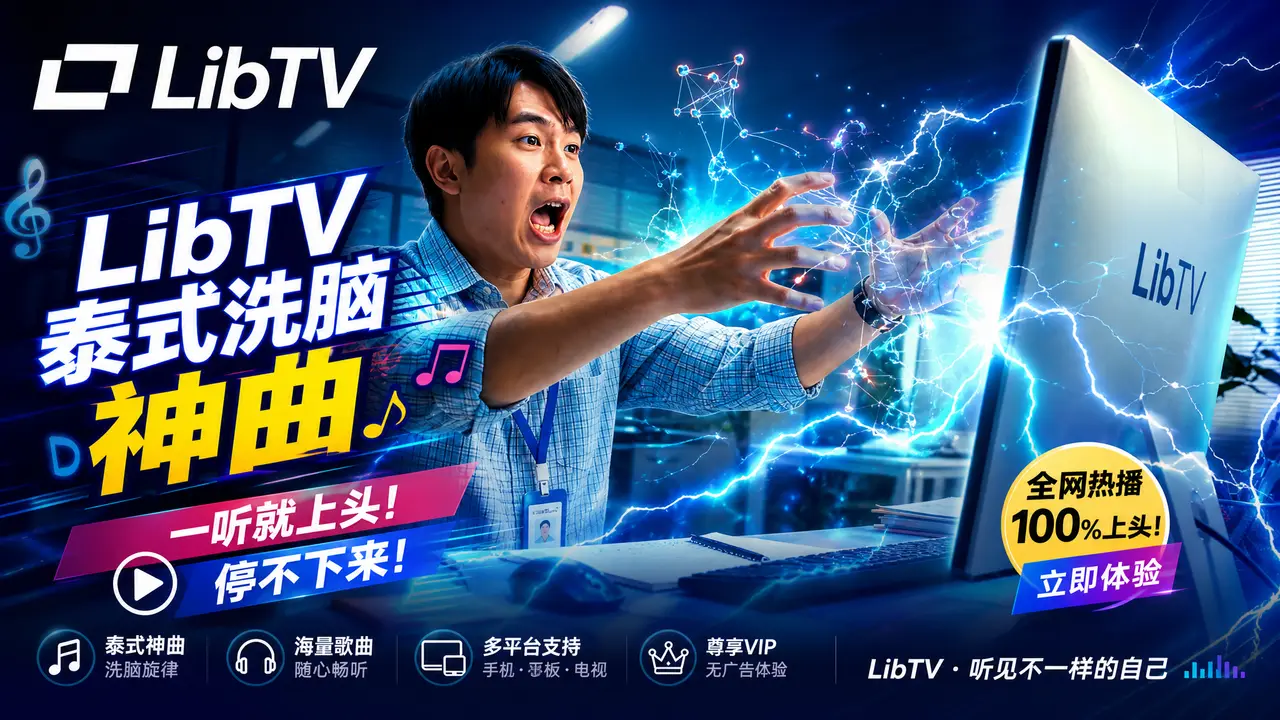 图片节点 17
LibTV泰式洗脑广告海报;不要泰语,可以显示中文;泰式洗脑神曲等
 视频截图视频节点 4
【画面内容】 分镜一:00:00-00:02.20 景别:夜市舞台全景。 构图:创意卡片、角色卡、镜头卡像彩纸一样散开旋转。 运镜手法:俯拍旋转后快速下切。 画面内容:对应“创意散散散”的延续,画面短暂形成彩色创意风暴。 分镜二:00:02.20-00:04.20 景别:主角中近景。 构图:主角双手向右一拉,半透明 LibTV 画布从夜市舞台右侧展开。 运镜手法:跟随拖拽动作横移。 画面内容:对应“拉进 LibTV”,散开的创意节点被吸进画布入口。 分镜三:00:04.20-00:06.00 景别:工作台画布近景。 构图:参考 LibTV 真实页面截图的暗色点阵创作画布打开,一个发光节点从中心跳出来,左侧资产栏弱化为背景结构。 运镜手法:快速推入画布。 画面内容:对应“一张画布开,一个节点来”,LibTV 的真实暗色点阵画布、节点卡片和连线概念必须清楚,但不要生成账号、积分、头像或密集小字。 分镜四:00:06.00-00:08.50 景别:节点中景。 构图:脚本节点和分镜节点依次进入画布,连线出现。 运镜手法:横向滑轨跟随节点落位。 画面内容:对应“脚本分镜”,两类节点从混乱中跳出并吸附到画布,不要出现随机中文。 分镜五:00:08.50-00:10.80 景别:节点中近景。 构图:角色节点、视频节点一前一后跳出。 运镜手法:轻微俯拍后快速拉平。 画面内容:对应“角色视频”,角色卡和视频卡进入同一条工作流。 分镜六:00:10.80-00:13.96 景别:画布全景。 构图:脚本、分镜、角色、视频节点排成一个工作台,背后夜市舞台和合唱队再次出现。 运镜手法:先横向滑轨展示节点,再轻微后拉露出最终合唱空间。 画面内容:对应“排成工作台”以及 Final Chorus 开头,产品画布清楚,随后全员准备进入最终合唱。 【声音与字幕】 @ {{Mixed 1}} 作为唯一节奏驱动。女声和男声保持画外合唱感,男主只做产品操作、节点拖拽和短促口号反应,不逐字对口型。功能词建议后期叠加,模型画面只保留空白节点卡和图形,不要生成真实 UI 或乱码文字。
【画面内容】 分镜一:00:00-00:02.20 景别:办公室到夜市转场中景。 构图:办公室墙面像广告舞台布景一样左右打开,泰式脑内夜市灯牌和合唱队从缝隙里冒出来。 运镜手法:快速后拉,露出空间变化。 画面内容:延续上一条第一次拖拽后,主角被拉入脑内夜市舞台,色彩突然变热闹。 分镜二:00:02.20-00:04.40 景别:左侧中景。 构图:脑内编剧从画面左侧冲出,手里挥舞混乱脚本纸,纸张飞散。 运镜手法:从主角快速左摇到编剧。 画面内容:对应“脚本在这边”,脚本纸只出现图形和空白纸,不要出现可读乱码。 分镜三:00:04.40-00:06.60 景别:右侧中景。 构图:摄影师、分镜卡、镜头图标从画面右侧冲出,与左侧脚本形成拉扯。 运镜手法:快速右摇,带轻微运动模糊。 画面内容:对应“分镜在那边”,分镜卡和镜头节点在右侧乱晃。 分镜四:00:06.60-00:08.80 景别:全景。 构图:角色设定卡像小演员一样跑出画面边缘,主角伸手抓不住。 运镜手法:跟随角色卡向外移动,再迅速拉回主角。 画面内容:对应“角色跑太远”,角色卡片脱离工作流,形成喜剧追逐。 分镜五:00:08.80-00:10.80 景别:仰拍中景。 构图:大量素材卡、视频缩略图、图片节点从上方像彩纸一样落下。 运镜手法:上摇到素材雨,再下摇回主角。 画面内容:对应“素材堆满天”,素材满天飞,但不要遮住主角脸。 分镜六:00:10.80-00:12.40 景别:主角中景。 构图:主角站在夜市舞台中央,左右两边是混乱节点。 运镜手法:低角度轻微推近。 画面内容:对应“别乱猜 / 别重来”,主角摆手制止混乱继续扩大,合唱队把飞散节点往中间推。 分镜七:00:12.40-00:14.04 景别:主角半身近景。 构图:所有混乱节点聚成一团光点,被主角双手抓住。 运镜手法:跟随双手聚拢动作轻微推近。 画面内容:对应“把灵感都拉进来”,主角把所有灵感收进手里,右侧半透明 LibTV 画布亮起,为下一条四连拉蓄势。 【声音与字幕】 {{Mixed 1}} 作为唯一节奏驱动。女声和男声属于画外领唱与群体回应,男主不完整演唱本段歌词,只跟随节奏做拖拽、转身、聚拢动作。不要生成歌词字幕,功能词和歌词后期叠加。
【画面内容】 分镜一:00:00-00:01.60 景别:办公室中近景。 构图:主角坐在电脑前,桌面堆满便利贴、草稿、素材卡片,电脑屏幕冷光照在脸上。 运镜手法:轻微手持推近。 画面内容:对应“点子太多?”,主角面前的灵感卡片同时弹起,像被广告音效震起来,表情惊讶但喜剧化。 分镜二:00:01.60-00:03.60 景别:广角中景。 构图:工作流线条在主角周围打结,脚本纸、分镜卡、角色设定和素材缩略图互相缠绕。 运镜手法:轻微鱼眼喜剧畸变,快速小幅环绕。 画面内容:对应“流程太乱?”,主角被混乱流程线绕住,但不能恐怖,必须像泰式广告喜剧里的夸张困境。 分镜三:00:03.60-00:06.19 景别:主角半身近景。 构图:主角突然抬头,双手抓住一团发光节点,电脑屏幕右侧打开抽象 LibTV 画布入口。 运镜手法:快速推近后轻微停顿,再跟随手部向画布方向一拉。 画面内容:对应“来,拉一下”,主角第一次做统一拖拽动作,发光节点被拉进电脑里的 LibTV 画布入口。 【声音与字幕】 {{Mixed 1}} 1 作为唯一节奏驱动。女声是画外广告女声或脑内领唱,男主不逐字对口型,只做表情反应和“拉一下”的动作口型。不要生成可读中文歌词字幕,正式字幕后期添加。
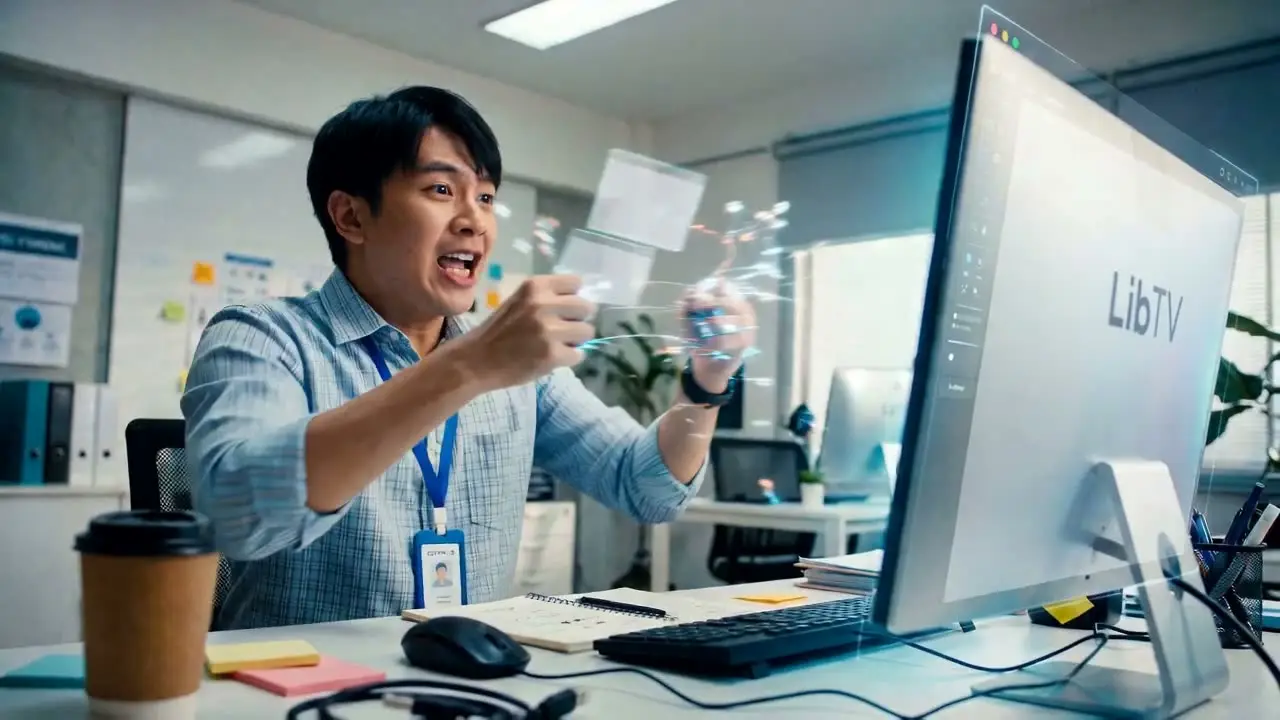 视频截图视频节点 4
【画面内容】 分镜一:00:00-00:01.00 景别:强拍近景。 构图:主角双手抓住脚本节点。 运镜手法:第一下强拍硬切。 画面内容:对应第一声“拉!”,脚本节点被吸入画布中心。 分镜二:00:01.00-00:02.00 景别:强拍近景。 构图:主角抓住分镜和角色节点。 运镜手法:第二下强拍硬切,轻微画面震动。 画面内容:对应第二声“拉!”,分镜和角色节点吸入画布。 分镜三:00:02.00-00:03.00 景别:强拍近景到中景。 构图:视频节点、修改节点和剩余素材一起汇聚。 运镜手法:第三下强拍硬切后快速推向中心。 画面内容:对应第三声“拉!”,所有节点完成吸附,画布发光。 分镜四:00:03.00-00:04.90 景别:干净品牌落版空间。 构图:画面从热闹泰式舞台收束成参考真实截图的干净暗色点阵工作台画布,中央留出品牌字位。 运镜手法:由动态快速收为稳定静止。 画面内容:对应最后“LibTV!”,中央留空给后期叠加:LibTV / AI 创作者工作台。画面不要自动生成文字。 【声音与字幕】 {{Mixed 4}} 作为唯一节奏驱动。三次“拉!”可以让男主或群像做夸张口型,最后“LibTV!”可做群体口号,但不要让男主完整演唱。结尾必须稳定干净,不要拖尾,不要随机文字。
【画面内容】 分镜一:00:00-00:01.00 景别:强拍近景。 构图:主角双手抓住脚本节点。 运镜手法:第一下强拍硬切。 画面内容:对应第一声“拉!”,脚本节点被吸入画布中心。 分镜二:00:01.00-00:02.00 景别:强拍近景。 构图:主角抓住分镜和角色节点。 运镜手法:第二下强拍硬切,轻微画面震动。 画面内容:对应第二声“拉!”,分镜和角色节点吸入画布。 分镜三:00:02.00-00:03.00 景别:强拍近景到中景。 构图:视频节点、修改节点和剩余素材一起汇聚。 运镜手法:第三下强拍硬切后快速推向中心。 画面内容:对应第三声“拉!”,所有节点完成吸附,画布发光。 分镜四:00:03.00-00:04.90 景别:干净品牌落版空间。 构图:画面从热闹泰式舞台收束成参考真实截图的干净暗色点阵工作台画布,中央留出品牌字位。 运镜手法:由动态快速收为稳定静止。 画面内容:对应最后“LibTV!”,中央留空给后期叠加:LibTV / AI 创作者工作台。画面不要自动生成文字。 【声音与字幕】 {{Mixed 2}} 作为唯一节奏驱动。三次“拉!”可以让男主或群像做夸张口型,最后“LibTV!”可做群体口号,但不要让男主完整演唱。结尾必须稳定干净,不要拖尾,不要随机文字。
【画面内容】 分镜一:00:00-00:02.00 景别:夜市大远景到男主全身。 构图:男主站在画面中央,整条泰式夜市突然像纸片舞台一样开始松动。霓虹灯牌、串灯、小吃摊、脚本卡、分镜框、视频素材、角色卡片全部围绕男主轻微错位旋转。 运镜手法:快速后拉加轻微鱼眼畸变,让夜市像一个正在失控的创作宇宙。 画面内容:对应“脑子乱乱乱”。男主从震惊变成“我来处理”的夸张表情。此时不要出现侧边 LibTV 画布。 分镜二:00:02.00-00:03.60 景别:男主全身动态镜头。 构图:男主双手抓住空中的发光节点线,向镜头方向猛拉。整条夜市不是被吸到右侧,而是从远处开始一层层向画面中心折叠,像纸扇、舞台布景、立体分镜板一样折进男主身前的 LibTV 标志形入口。 运镜手法:镜头被男主的动作一起拉向中心,产生“观众也被拉进去”的穿越感。 画面内容:对应第一次“拉进 LibTV”。夜市灯牌、摊位、素材碎片在折叠过程中变成节点、连线和卡片,进入画面中心的 LibTV 创作入口。 分镜三:00:03.60-00:04.90 景别:穿越入口后的空间爆发。 构图:镜头穿过入口后,进入一个由 LibTV 点阵组成的黑色创作空间。刚被折叠进来的夜市世界突然爆成一圈彩色创意烟花,节点卡片从中心向四周炸开。 运镜手法:快速穿越后接短促闪白,随后轻微慢动作展开。 画面内容:对应“创意散散散”。脚本、分镜、角色、视频、素材、音乐节奏块在空间中散开,但不要生成可读文字。 分镜四:00:04.90-00:06.10 景别:正面中心构图。 构图:男主站在 LibTV 点阵空间中央,双手从前方猛地向自己胸前一拉。所有散开的节点被拉成一条清晰的创作流程线,从男主身后向远处延伸,形成完整工作台空间。 运镜手法:镜头快速推入工作流中心,最后稳定。 画面内容:对应第二次“拉进 LibTV”。不是再次吸入画布,而是镜头进入 LibTV 内部,看见混乱世界已经变成有秩序的节点工作流。 分镜五:00:06.10-00:07.00 景别:男主中心定格中景。 构图:男主站在 LibTV 点阵工作台空间中央,身后节点工作流稳定排列,霓虹色光从夜市元素转化为干净的工作台光线。 运镜手法:轻微推近,最后定格。 画面内容:不新增剧情,只保持“整个世界已经被拉进 LibTV”的完成感,为后面的“拉!拉!拉!LibTV!”留出剪辑衔接空间。 【声音与字幕】 {{Mixed 3}} 作为唯一节奏驱动。女声和男声都是画外广告神曲,不要求男主逐字演唱。 男主只在两次“拉进 LibTV”的“拉”和“LibTV”上做短促夸张口型。 不要生成可读歌词字幕,不要生成乱码文字。 正式字幕后期在剪映叠加。
【画面内容】 分镜一:00:00-00:02.40 景别:夜市场景全景到男主中景。 构图:男主站在画面中央,泰式夜市从四周包围他。脚本纸、分镜框、角色卡、视频缩略图、发光节点从他头顶爆出,围成高速旋转的创意风暴。 运镜手法:轻微鱼眼广角,镜头围绕男主小幅旋转,配合“乱乱乱”做三次短促震动。 画面内容:对应“脑子乱乱乱”。男主表情夸张崩溃,像被创意电流击中。此时不要吸入 LibTV,只表现乱。 分镜二:00:02.40-00:04.10 景别:男主全身到低角度中景。 构图:男主双手抓住空中的节点线,不往右拉,而是猛地向下拉。脚下夜市地面瞬间裂开成 LibTV 暗色点阵工作台,像舞台地板变成巨大创作画布。 运镜手法:低角度推近,镜头跟着男主双手向下猛沉,产生强烈坠落感。 画面内容:对应第一次“拉进 LibTV”。混乱节点像雨点一样被拉进脚下点阵地面,落地后变成脚本、分镜、角色、视频节点。 分镜三:00:04.10-00:05.30 景别:俯拍到男主反应。 构图:脚下刚排好的节点突然像弹簧一样从地面弹起,变成彩纸和发光卡片,再次飞满男主周围。 运镜手法:快速俯拍后拉,给飞散节点空间。 画面内容:对应“创意散散散”。男主抬头看着节点重新乱飞,表情变成“怎么又来了”的夸张崩溃感。 分镜四:00:05.30-00:06.20 景别:中心环绕构图。 构图:男主站在中央,双手从身体两侧向胸前猛拉。所有飞散节点被拉成一圈环绕男主的发光工作流圆环,节点、连线、卡片瞬间卡位。 运镜手法:镜头环绕男主半圈,最后回到正面。 画面内容:对应第二次“拉进 LibTV”。工作流圆环在男主身后亮起,变成干净有秩序的 LibTV 点阵工作台空间。 分镜五:00:06.20-00:07.00 景别:男主中心定格中景。 构图:男主保持夸张拉完姿势,身后工作流圆环稳定发光。 运镜手法:轻微推近,霓虹灯跟着尾音闪一下。 画面内容:不新增动作,只保留洗脑姿势和 LibTV 工作流完成状态,为下一段剪辑留缓冲。 【声音与字幕】 {{Mixed 3}} 作为唯一节奏驱动。女声和男声都是画外广告神曲,不要求男主逐字演唱。 男主只在两次“拉进 LibTV”的“拉”和“LibTV”上做短促夸张口型。 不要生成可读歌词字幕,不要生成乱码文字。 正式字幕后期在剪映叠加。
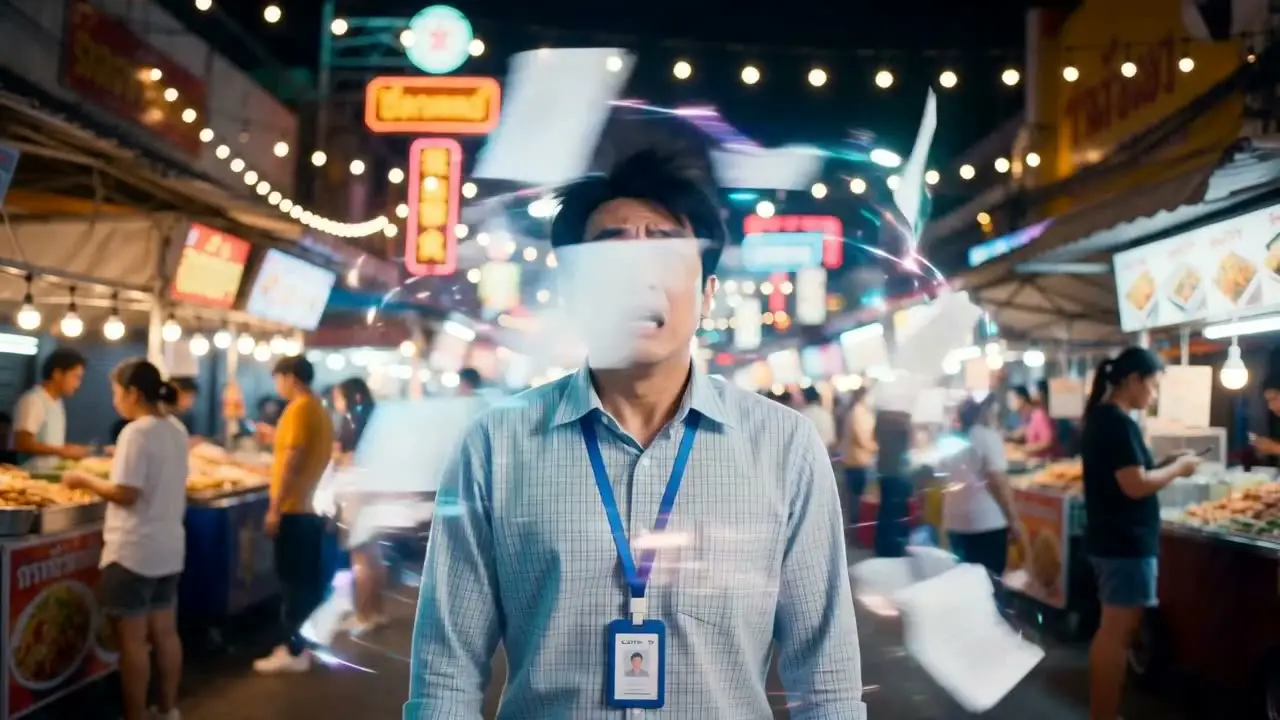 视频截图视频节点 4
【画面内容】 分镜一:00:00-00:02.60 景别:夜市场景全景到男主中景。 构图:男主一个人站在泰式夜市中央,周围没有其他主角。脚本纸、分镜框、角色卡、视频缩略图、发光节点突然从他头顶和身体周围爆出,形成一圈高速旋转的脑内创意风暴。 运镜手法:轻微鱼眼广角,三次短促震动,对应“乱乱乱”。 画面内容:对应“脑子乱乱乱”。男主表情夸张崩溃,身体被节点线拉扯,像被创意电流击中。此时不要吸入 LibTV,只表现乱。 分镜二:00:02.60-00:04.60 景别:男主半身中近景。 构图:男主突然抓住空中的混乱节点,双手往胸前一收,身体夸张后仰,脚下一滑,然后猛地向右侧 LibTV 暗色点阵画布一拉。 运镜手法:镜头跟随手部向右快速横移,节点拖出光线轨迹。 画面内容:对应第一次“拉进 LibTV”。所有节点像被强力吸尘器吸走一样冲进 LibTV 画布,右侧出现暗色点阵画布、节点卡片和连接线。 分镜三:00:04.60-00:05.80 景别:LibTV 画布近景到男主反应。 构图:刚进入画布的节点突然又从画布边缘弹出来,像彩纸爆炸一样散开,脚本、分镜、角色、视频节点再次飞满男主周围。 运镜手法:快速后拉,给散开的节点空间。 画面内容:对应“创意散散散”。男主一脸“又来了”的夸张崩溃表情。必须看见创意重新散开,不要直接排成工作流。 分镜四:00:05.80-00:06.80 景别:男主与 LibTV 画布二分构图。 构图:男主第二次抓住所有散开的创意节点,这次动作更狠,双手猛拉,身体后仰到夸张程度,整个夜市场景产生轻微透视变形。 运镜手法:第二次跟随拖拽向右,最后 0.2 秒稳定住。 画面内容:对应第二次“拉进 LibTV”。所有散开的创意瞬间吸回 LibTV 暗色点阵画布,节点吸附成清楚工作流,画面停在干净、有秩序的节点画布上,为后面产品段衔接。 【声音与字幕】 @音频1 作为唯一节奏驱动。女声和男声都是画外广告神曲,不要求男主逐字演唱。 男主只在两次“拉进 LibTV”的“拉”和“LibTV”上做短促夸张口型。 不要生成可读歌词字幕,不要生成乱码文字。 正式字幕后期在剪映叠加。
【画面内容】 分镜一:00:00-00:02.40 景别:夜市场景全景到男主中景。 构图:男主站在画面中央,泰式夜市从四周包围他。脚本纸、分镜框、角色卡、视频缩略图、发光节点从他头顶爆出,围成高速旋转的创意风暴。 运镜手法:轻微鱼眼广角,镜头围绕男主小幅旋转,配合“乱乱乱”做三次短促震动。 画面内容:对应“脑子乱乱乱”。男主表情夸张崩溃,像被创意电流击中。此时不要吸入 LibTV,只表现乱。 分镜二:00:02.40-00:04.10 景别:男主全身到低角度中景。 构图:男主双手抓住空中的节点线,不往右拉,而是猛地向下拉。脚下夜市地面瞬间裂开成 LibTV 暗色点阵工作台,像舞台地板变成巨大创作画布。 运镜手法:低角度推近,镜头跟着男主双手向下猛沉,产生强烈坠落感。 画面内容:对应第一次“拉进 LibTV”。混乱节点像雨点一样被拉进脚下点阵地面,落地后变成脚本、分镜、角色、视频节点。 分镜三:00:04.10-00:05.30 景别:俯拍到男主反应。 构图:脚下刚排好的节点突然像弹簧一样从地面弹起,变成彩纸和发光卡片,再次飞满男主周围。 运镜手法:快速俯拍后拉,给飞散节点空间。 画面内容:对应“创意散散散”。男主抬头看着节点重新乱飞,表情变成“怎么又来了”的夸张崩溃感。 分镜四:00:05.30-00:06.20 景别:中心环绕构图。 构图:男主站在中央,双手从身体两侧向胸前猛拉。所有飞散节点被拉成一圈环绕男主的发光工作流圆环,节点、连线、卡片瞬间卡位。 运镜手法:镜头环绕男主半圈,最后回到正面。 画面内容:对应第二次“拉进 LibTV”。工作流圆环在男主身后亮起,变成干净有秩序的 LibTV 点阵工作台空间。 分镜五:00:06.20-00:07.00 景别:男主中心定格中景。 构图:男主保持夸张拉完姿势,身后工作流圆环稳定发光。 运镜手法:轻微推近,霓虹灯跟着尾音闪一下。 画面内容:不新增动作,只保留洗脑姿势和 LibTV 工作流完成状态,为下一段剪辑留缓冲。 【声音与字幕】 {{Mixed 1}} 作为唯一节奏驱动。女声和男声都是画外广告神曲,不要求男主逐字演唱。 男主只在两次“拉进 LibTV”的“拉”和“LibTV”上做短促夸张口型。 不要生成可读歌词字幕,不要生成乱码文字。 正式字幕后期在剪映叠加。
【画面内容】 分镜一:00:00-00:02.00 景别:夜市大远景到男主全身。 构图:男主站在画面中央,整条泰式夜市突然像纸片舞台一样开始松动。霓虹灯牌、串灯、小吃摊、脚本卡、分镜框、视频素材、角色卡片全部围绕男主轻微错位旋转。 运镜手法:快速后拉加轻微鱼眼畸变,让夜市像一个正在失控的创作宇宙。 画面内容:对应“脑子乱乱乱”。男主从震惊变成“我来处理”的夸张表情。此时不要出现侧边 LibTV 画布。 分镜二:00:02.00-00:03.60 景别:男主全身动态镜头。 构图:男主双手抓住空中的发光节点线,向镜头方向猛拉。整条夜市不是被吸到右侧,而是从远处开始一层层向画面中心折叠,像纸扇、舞台布景、立体分镜板一样折进男主身前的 LibTV 标志形入口。 运镜手法:镜头被男主的动作一起拉向中心,产生“观众也被拉进去”的穿越感。 画面内容:对应第一次“拉进 LibTV”。夜市灯牌、摊位、素材碎片在折叠过程中变成节点、连线和卡片,进入画面中心的 LibTV 创作入口。 分镜三:00:03.60-00:04.90 景别:穿越入口后的空间爆发。 构图:镜头穿过入口后,进入一个由 LibTV 点阵组成的黑色创作空间。刚被折叠进来的夜市世界突然爆成一圈彩色创意烟花,节点卡片从中心向四周炸开。 运镜手法:快速穿越后接短促闪白,随后轻微慢动作展开。 画面内容:对应“创意散散散”。脚本、分镜、角色、视频、素材、音乐节奏块在空间中散开,但不要生成可读文字。 分镜四:00:04.90-00:06.10 景别:正面中心构图。 构图:男主站在 LibTV 点阵空间中央,双手从前方猛地向自己胸前一拉。所有散开的节点被拉成一条清晰的创作流程线,从男主身后向远处延伸,形成完整工作台空间。 运镜手法:镜头快速推入工作流中心,最后稳定。 画面内容:对应第二次“拉进 LibTV”。不是再次吸入画布,而是镜头进入 LibTV 内部,看见混乱世界已经变成有秩序的节点工作流。 分镜五:00:06.10-00:07.00 景别:男主中心定格中景。 构图:男主站在 LibTV 点阵工作台空间中央,身后节点工作流稳定排列,霓虹色光从夜市元素转化为干净的工作台光线。 运镜手法:轻微推近,最后定格。 画面内容:不新增剧情,只保持“整个世界已经被拉进 LibTV”的完成感,为后面的“拉!拉!拉!LibTV!”留出剪辑衔接空间。 【声音与字幕】 {{Mixed 1}} 作为唯一节奏驱动。女声和男声都是画外广告神曲,不要求男主逐字演唱。 男主只在两次“拉进 LibTV”的“拉”和“LibTV”上做短促夸张口型。 不要生成可读歌词字幕,不要生成乱码文字。 正式字幕后期在剪映叠加。
 视频截图视频节点 4
【画面内容】 分镜一:00:00-00:02.40 景别:脚本节点近景。 构图:脑内编剧举着混乱脚本纸,脚本节点在他身边乱跳。 运镜手法:强拍硬切,轻微屏幕震动。 画面内容:对应“不会写?拉!”,主角抓住脚本节点,往 LibTV 画布方向一拉,节点吸附到画布第一格。 分镜二:00:02.40-00:04.80 景别:分镜/拍摄节点中景。 构图:摄影师、镜头图标、分镜卡在画面里左右乱晃。 运镜手法:快速横移跟拍。 画面内容:对应“不会拍?拉!”,主角重复同一个拖拽动作,把分镜/镜头节点拉进画布第二格。 分镜三:00:04.80-00:07.20 景别:时间线节点近景。 构图:视频素材条、剪辑线、硬盘图标乱成一团。 运镜手法:俯拍到平视的快速转场。 画面内容:对应“不会剪?拉!”,剪辑节点被拉进画布第三格,乱线瞬间变直。 分镜四:00:07.20-00:09.60 景别:修改节点中景。 构图:红色修改意见、角色设定卡和美术色块乱飞。 运镜手法:推近到吸附点。 画面内容:对应“不会改?拉!”,修改节点吸附,四类节点全部进入 LibTV 画布。 分镜五:00:09.60-00:11.80 景别:夜市舞台全景。 构图:全员在画布前合唱,四类节点发光。 运镜手法:快速后拉。 画面内容:对应“脑子乱乱乱”,全场喜剧混乱短暂爆发,但四类节点已经被画布控制住。 分镜六:00:11.80-00:13.97 景别:主角与画布二分构图。 构图:主角在左侧做再次拖拽动作,右侧 LibTV 画布吸入创意风暴。 运镜手法:跟随拖拽动作横向移动。 画面内容:对应“拉进 LibTV / 创意散散散”的开头,混乱创意开始向画布聚拢,为下一段产品展示衔接。 【声音与字幕】 {{Mixed 1}} 作为唯一节奏驱动。女声可作为提问领唱,男声可作为“拉!”回应;男主只在四次“拉!”和“LibTV”这类短促口号上做夸张口型,不要让男主逐字唱完整段。不要生成歌词字幕。四次“拉!”必须动作清晰、重复、可记忆。