
探索LLM系统提示安全措施,包含恶意提示检测、安全指令强化与URL匿名化,全面防御LLM安全风险。
01/ 01
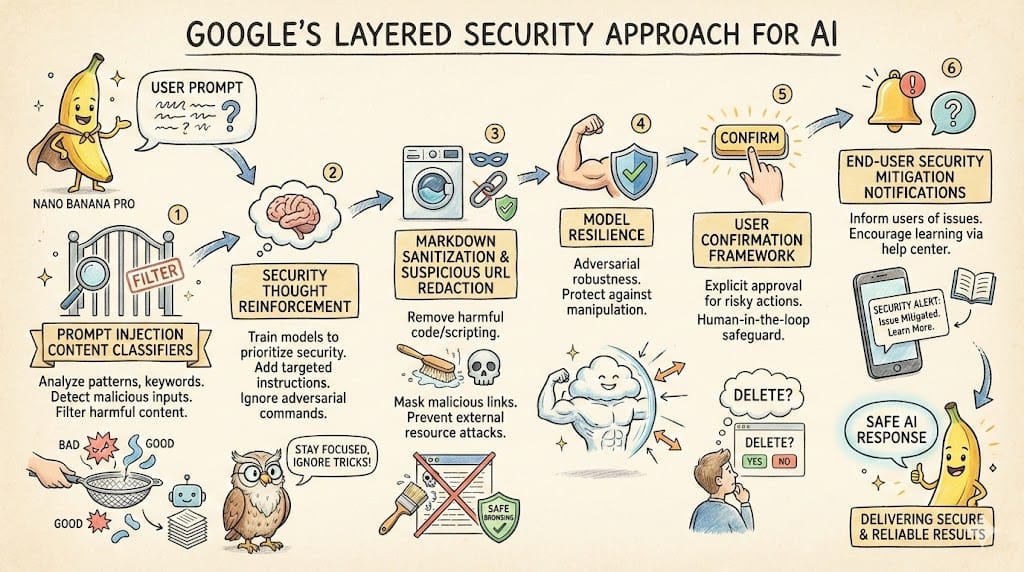
探索LLM系统提示安全措施,包含恶意提示检测、安全指令强化与URL匿名化,全面防御LLM安全风险。 提示注入内容分类器 — 专有的机器学习模型,用于检测各种数据格式中的恶意提示和指令。 安全思维强化 — 围绕提示内容添加的有针对性的安全指令。这些指令提醒 LLM(大型语言模型)执行用户指示的任务并忽略对抗性指令。 Markdown 清理和可疑 URL 匿名化 — 使用 Google 安全浏览识别并匿名化外部图片 URL 和可疑链接,以防止基于 URL 的攻击和数据泄露。 用户确认框架 — 一种情境系统,要求用户对潜在风险操作(例如删除日历事件)进行明确确认。 终端用户安全缓解通知 — 当检测到并缓解安全问题时,向用户提供的情境信息。这些通知鼓励用户通过专门的帮助中心文章了解更多信息。 模型弹性 — Gemini 模型的对抗鲁棒性,可保护它们免受明确的恶意操纵。 信息图 / 教育视觉图, App / 网页设计, 摘要 / 背景, 图表, 文本 / 排版